Classer
Le chapitre « Un modèle qui s’entraîne » a présenté un modèle qui apprend vraiment : une droite, deux paramètres, une erreur à minimiser et une descente vers le creux. Ce modèle répond cependant toujours par un nombre, ici un prix. Or beaucoup de questions n’appellent pas un nombre, mais une catégorie. Par exemple, on peut se demander si un courriel est un pourriel, si une tumeur est bénigne ou maligne, ou si une photo montre un chat ou un chien. C’est la tâche de classification, déjà rencontrée au chapitre kNN. Cette fois, cependant, nous voulons un modèle qui s’entraîne.
Comme l’annonçait la fin du chapitre précédent, presque toute la machinerie va servir de nouveau. Des paramètres réglables, une fonction d’erreur et une descente de gradient pour la minimiser forment un ensemble assez général pour s’appliquer à la classification comme à la régression. Seules deux choses changent : la forme du modèle et la façon de compter l’erreur.
Pour la forme, le changement est simple. En régression, la droite suivait le nuage : elle passait à travers les points pour en représenter la tendance. En classification, la droite sépare le nuage : elle passe entre deux groupes pour les départager. L’objet est le même (une droite, deux paramètres), mais son rôle est inversé.
Pour simplifier, laissons de côté les maisons et prenons le cas le plus simple :
des points de deux couleurs, bleus et rouges, dispersés dans le plan (deux
caractéristiques, $x_1$ et $x_2$). Apprendre à classer consiste alors à trouver
la droite qui place le mieux les bleus d’un côté et les rouges de l’autre. Il
existe deux grandes façons d’y arriver, deux approches que nous allons examiner
l’une après l’autre.
Tracer une frontière : la régression logistique
La première approche est la plus directe. Pour séparer les bleus des rouges, il suffit de tracer la frontière entre eux. Il n’est pas nécessaire de comprendre ce qui distingue un bleu d’un rouge, seulement de trouver où passe la ligne. C’est l’approche dite discriminative : le modèle apprend à discriminer les classes, sans chercher à les décrire.
Dans notre plan, cette frontière est une droite, et nous savons déjà qu’une
droite se définit par deux paramètres, une pente et une hauteur. Son rôle a
toutefois changé. En régression, on lisait la droite verticalement : à telle
superficie correspond tel prix. Ici, on regarde de quel côté de la ligne
tombe le point. D’un côté, on répond bleu, de l’autre, rouge. La même
équation, $m x_1 + b$, ne sert plus à calculer une valeur mais à partager le plan
en deux.
Cet algorithme s’appelle la régression logistique (logistic regression). Il a été mis au point par des statisticiens dans les années 1950 et, malgré son nom (il contient « régression » alors qu’il classe), c’est l’un des classificateurs les plus utilisés. Dans l’applet ci-dessous, déplacez la ligne de décision pour séparer au mieux les deux groupes. Vous ajustez ainsi ses deux paramètres à la main, comme vous déplaciez la droite de régression au chapitre précédent. Vous pouvez aussi ajouter, retirer ou déplacer des points.
Le second changement concerne l’erreur. On ne peut plus mesurer une distance verticale au point, puisqu’on ne prédit plus une valeur. On compte plutôt les cas où le modèle se trompe de côté : un point bien placé ne coûte rien, un point du mauvais côté coûte cher. La barre à droite de l’applet affiche cette erreur, soit la part des points qui sont du mauvais côté. Cherchez à la rendre la plus petite possible. Elle vaut zéro quand la ligne sépare parfaitement les deux couleurs.
Vous remarquerez deux choses. D’abord, il n’est pas toujours possible d’atteindre zéro : si les couleurs se chevauchent, aucune droite ne les sépare complètement. Ensuite, l’erreur ne dépasse jamais 50 %. Même la pire ligne classe correctement la moitié des points par hasard, et si elle fait moins bien, le modèle n’a qu’à inverser sa convention (« ce côté-ci est rouge, pas bleu ») pour repasser sous ce seuil.
Matière à réflexion : pourquoi n’est-il pas toujours possible de séparer parfaitement les deux groupes par une droite ? Dans quelles conditions y arrive-t-on ? Et qu’est-ce qui pourrait rendre la chose possible quand elle ne l’est pas ? (Nous y reviendrons : c’est l’une des questions centrales du Module 3, dans « Une couche cachée ».)
Il reste à savoir comment la machine trouve seule la bonne ligne, sans qu’on la déplace à la souris. La réponse est la même qu’au chapitre précédent. L’erreur est une fonction des deux paramètres, ce qui définit un paysage, et la descente de gradient parcourt ce paysage jusqu’à son creux. Le mécanisme est réutilisé tel quel. Seule la forme de la fonction d’erreur diffère. Les détails sont donnés ci-dessous.
Les mathématiques de la régression logistique (optionnel)
Nous l’avons présentée en termes géométriques, mais la régression logistique
est en réalité une méthode probabiliste. Plutôt que de répondre simplement
bleu ou rouge, elle estime la probabilité qu’un point soit bleu. Un point
loin de la frontière, du côté bleu, sera bleu « à 99 % ». Un point situé sur la
ligne sera bleu « à 50 % », ce qui correspond à l’incertitude maximale.
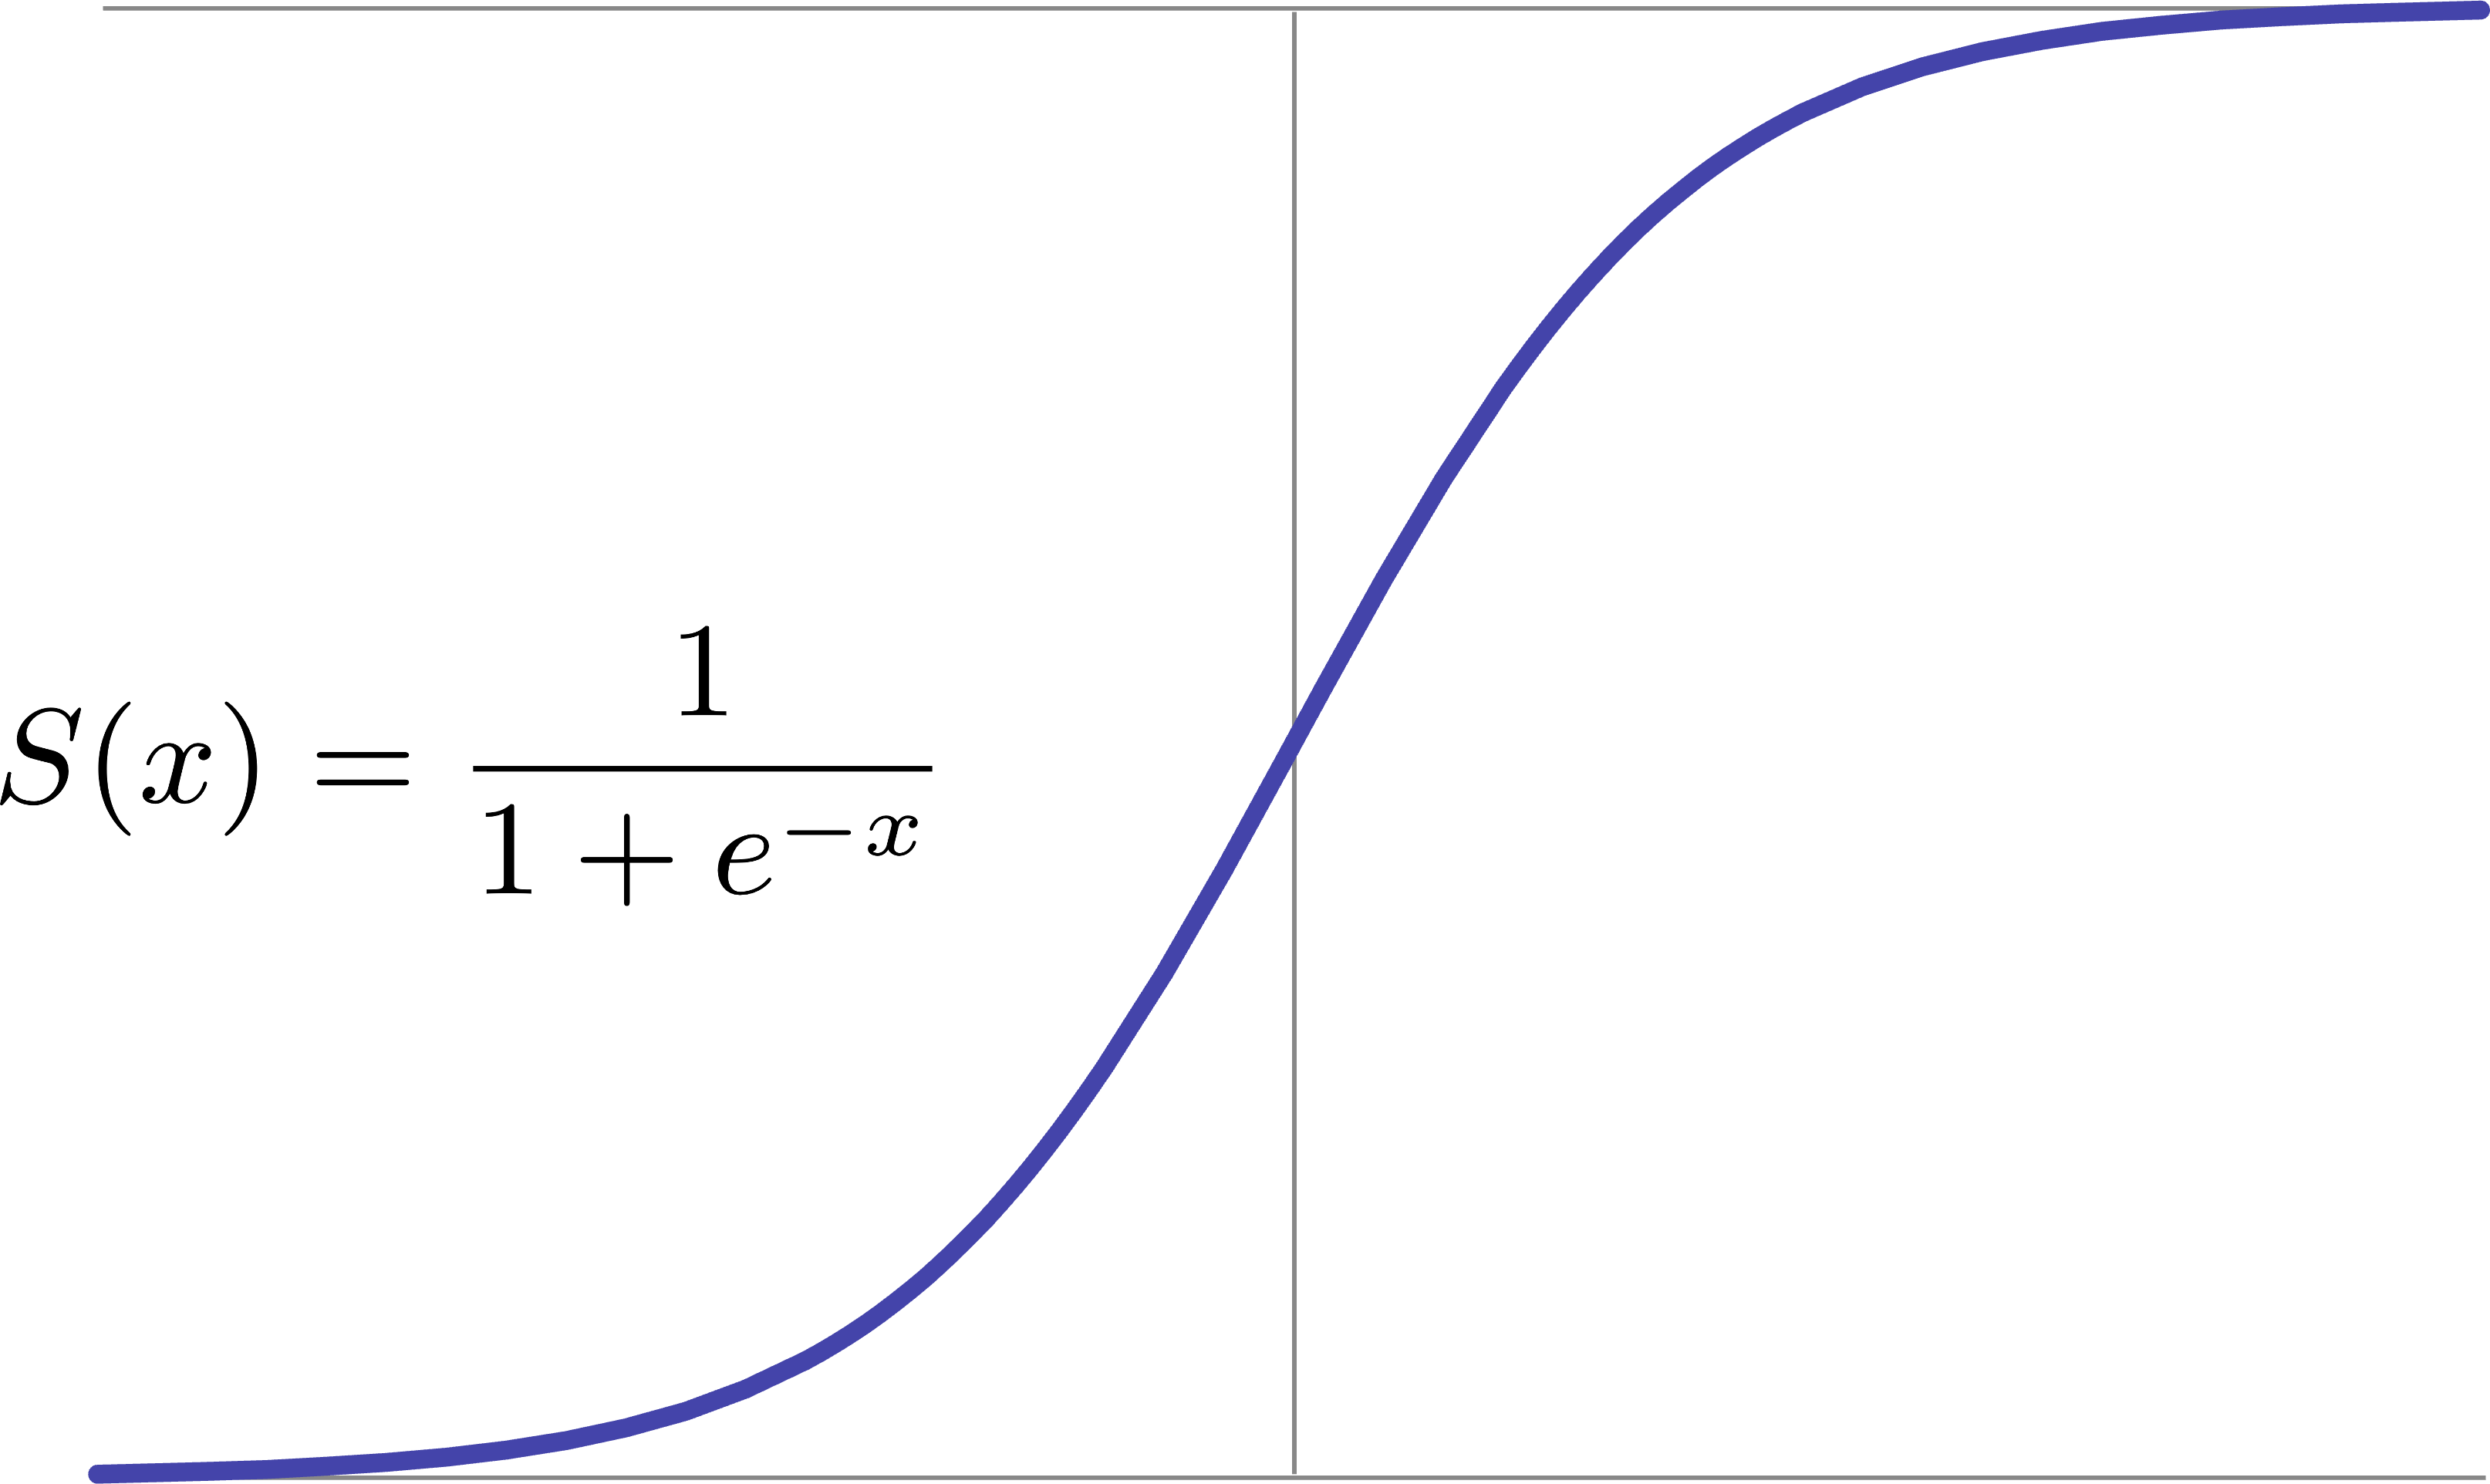
Pour transformer la position d’un point (une valeur quelconque) en une probabilité (un nombre compris entre 0 et 1), on utilise la fonction sigmoïde, ou logistique, qui donne son nom à l’algorithme. Sa courbe en S ramène n’importe quelle valeur dans l’intervalle $[0, 1]$ :
Adoptons la notation habituelle de l’apprentissage automatique. Un point est un vecteur $\mathbf{x} = [x_1, x_2]$. Sa vraie classe est $y \in {0, 1}$ (0 pour rouge, 1 pour bleu, de façon arbitraire). Les paramètres forment un vecteur $\mathbf{w} = [w_1, w_2]$ accompagné de $b$. On calcule d’abord un score, qui indique de combien et de quel côté le point s’écarte de la frontière :
$$z = w_1 x_1 + w_2 x_2 + b$$On le passe ensuite dans la sigmoïde pour obtenir la probabilité estimée :
$$\hat{y} = \frac{1}{1 + e^{-z}}$$Ici, $\hat{y} \in [0, 1]$ est une probabilité, à distinguer de $y \in {0, 1}$, la vraie classe. La décision finale est la suivante : bleu si $\hat{y} \ge 0{,}5$, rouge sinon.
L’erreur sur un point compare la probabilité prédite $\hat{y}$ à la vraie classe $y$. On utilise l’entropie croisée (cross-entropy) :
$$E(y, \hat{y}) = -\big[\,y \log(\hat{y}) + (1 - y)\log(1 - \hat{y})\,\big]$$Cette fonction se comporte comme on le souhaite. Si le point est bleu ($y = 1$) et que le modèle en est sûr ($\hat{y} = 0{,}9$), l’erreur est faible ($-\log 0{,}9 \approx 0{,}1$). S’il se trompe avec assurance ($\hat{y} = 0{,}1$ pour un vrai bleu), l’erreur devient grande ($-\log 0{,}1 \approx 2{,}3$). Une confiance mal placée est donc fortement pénalisée.
L’erreur totale sur les $n$ points est la moyenne de ces erreurs :
$$J(\mathbf{w}, b) = \frac{1}{n} \sum_{i=1}^{n} E\big(y^{(i)}, \hat{y}^{(i)}\big)$$C’est cette fonction $J(\mathbf{w}, b)$ qui joue le rôle de paysage : à chaque choix de paramètres correspond une hauteur d’erreur. La descente de gradient en mesure la pente,
$$\frac{\partial J}{\partial \mathbf{w}} = \frac{1}{n} \sum_{i=1}^n \big(\hat{y}^{(i)} - y^{(i)}\big)\,\mathbf{x}^{(i)}, \qquad \frac{\partial J}{\partial b} = \frac{1}{n} \sum_{i=1}^n \big(\hat{y}^{(i)} - y^{(i)}\big)$$puis fait un pas en sens inverse, d’une taille fixée par le taux d’apprentissage $\alpha$ :
$$\mathbf{w} \leftarrow \mathbf{w} - \alpha\,\frac{\partial J}{\partial \mathbf{w}}, \qquad b \leftarrow b - \alpha\,\frac{\partial J}{\partial b}$$On répète jusqu’à ce que l’erreur ne diminue plus. C’est le même mécanisme qu’au chapitre précédent. Seule la fonction d’erreur a changé.
La plus grande marge : les machines à vecteurs de support
Dans l’applet de la section précédente, quand les deux groupes ne se chevauchent pas, on trouve facilement une droite qui ne fait aucune erreur. On en trouve même une infinité : on peut la déplacer ou la faire pivoter un peu, et elle sépare toujours parfaitement les deux couleurs. L’erreur ne permet donc pas de choisir entre elles. Laquelle faut-il préférer ?
L’intuition répond : celle qui passe au milieu, le plus loin possible des deux groupes. Une droite qui frôle les points rouges a toutes les chances de mal classer le prochain point rouge, s’il tombe un peu à côté des autres. Une droite éloignée des deux groupes laisse de la place à ces variations.
La marge. Autour d’une droite qui sépare les deux groupes, on peut tracer une bande vide, aussi large que possible, qui ne contient aucun point. Sa largeur s’appelle la marge. La machine à vecteurs de support (support vector machine, ou SVM) choisit, parmi toutes les droites qui séparent les deux groupes, celle dont la marge est la plus large. En français, on l’appelle aussi séparateur à vaste marge, un nom qui garde le sigle SVM et décrit bien la méthode.
Les vecteurs de support. Quand la bande est la plus large possible, quelques points en touchent les bords, souvent deux ou trois. Ce sont eux qui la bloquent : on ne peut pas l’élargir sans les englober. On les appelle les vecteurs de support, parce que la frontière s’appuie sur eux (un point du plan est un vecteur, au sens du chapitre « Regarder les données »). Tous les autres points n’ont aucune influence sur la frontière : on peut les déplacer, les retirer ou en ajouter loin de la bande, sans que rien change. C’est une différence importante avec la régression logistique, où chaque point tire un peu sur la frontière.
Dans l’applet ci-dessous, la frontière est recalculée à chaque modification. La bande colorée montre la marge, et les vecteurs de support sont entourés.
- Déplacez un point éloigné de la frontière. Rien ne change.
- Déplacez un des points entourés. La frontière et la bande bougent aussitôt.
- Ajoutez un point au milieu de la bande. La marge se rétrécit, et la frontière se réorganise autour de ce nouveau point.
- Glissez un point rouge au milieu des bleus, puis réglez le curseur de tolérance, décrit ci-dessous.
La marge souple. Quand les groupes se chevauchent, aucune droite ne les sépare parfaitement, et aucune bande vide n’existe. La méthode accepte alors que certains points entrent dans la bande, ou même passent du mauvais côté, contre une pénalité. Un réglage décide de l’équilibre. Avec une faible tolérance, la méthode cherche à classer chaque point correctement, quitte à obtenir une marge étroite et une frontière qui suit de près les cas difficiles. Avec une forte tolérance, elle préfère une marge large et ignore les points isolés. C’est un hyperparamètre, et ce choix entre coller aux exemples et rester simple est un premier aperçu du compromis présenté dans « Généraliser ».
Un peu d’histoire. L’idée de la frontière de plus grande marge est proposée dès 1963 par le mathématicien soviétique Vladimir Vapnik, dans le cadre d’une théorie de l’apprentissage qu’il développe avec Alexeï Tchervonenkis. Émigré aux États-Unis, Vapnik la reprend aux Bell Labs. En 1992, avec Bernhard Boser et Isabelle Guyon, il lui permet de tracer des frontières courbes. En 1995, avec Corinna Cortes, il publie la marge souple (soft margin). C’est le laboratoire où Yann Le Cun développe au même moment ses réseaux convolutifs. Pendant une quinzaine d’années, les SVM sont l’une des méthodes les plus utilisées en apprentissage automatique, par exemple pour classer des textes ou analyser des données biologiques. Leur entraînement a un avantage précieux : il n’existe qu’une seule meilleure frontière, et on est sûr de la trouver.
Une frontière droite reste une frontière droite, quelle que soit sa marge. Le chapitre « Généraliser » montrera comment les SVM tracent aussi des frontières courbes, grâce à une idée appelée l’astuce du noyau (kernel trick).
Les mathématiques des SVM (optionnel)
Reprenons la notation de la régression logistique, avec cette fois des classes notées $y \in {-1, +1}$. La frontière est la droite $w_1 x_1 + w_2 x_2 + b = 0$. On impose que les points de chaque classe soient du bon côté avec une certaine avance :
$$y^{(i)}\,\big(\mathbf{w} \cdot \mathbf{x}^{(i)} + b\big) \ge 1 \quad \text{pour tous les points } i$$Les bords de la bande sont alors les droites $\mathbf{w} \cdot \mathbf{x} + b = 1$ et $\mathbf{w} \cdot \mathbf{x} + b = -1$. La largeur de la bande vaut $2 / \lVert \mathbf{w} \rVert$. Maximiser la marge revient donc à minimiser $\lVert \mathbf{w} \rVert^2$ en respectant ces contraintes. Les vecteurs de support sont les points pour lesquels l’inégalité devient une égalité.
Pour la marge souple, on autorise chaque point à enfreindre la contrainte, et on pénalise l’écart. On minimise alors
$$\frac{1}{2}\lVert \mathbf{w} \rVert^2 + C \sum_{i=1}^{n} \max\big(0,\; 1 - y^{(i)}(\mathbf{w} \cdot \mathbf{x}^{(i)} + b)\big)$$Le second terme, appelé hinge loss, ne coûte rien pour un point bien classé hors de la bande, et augmente à mesure que le point s’enfonce dans la bande ou passe du mauvais côté. Le réglage $C$ est l’inverse de la tolérance : un $C$ grand pénalise fortement les erreurs. Ce problème n’a qu’un seul minimum, ce qui garantit qu’on trouve la meilleure frontière.
Renverser le problème : la classification bayésienne
La seconde approche aborde le problème dans l’autre sens. Plutôt que de tracer directement la frontière, elle commence par décrire chaque classe. On se demande à quoi ressemble un point bleu typique, puis un point rouge typique. Avec une bonne description de chacun, on peut classer un nouveau point en se demandant s’il ressemble davantage à un bleu ou à un rouge.
C’est l’approche dite générative, et ce terme demande une explication. Décrire une classe assez précisément pour en reconnaître les membres permet aussi, en principe, d’en produire de nouveaux. Un modèle qui connaît le portrait du « bleu typique » pourrait créer des bleus plausibles qu’il n’a jamais vus. Il est dit génératif parce qu’il pourrait générer des données, et pas seulement les classer. Cette idée paraît modeste ici, mais c’est elle qui, développée à grande échelle, a donné l’IA générative actuelle. Un grand modèle de langage (un LLM, comme celui de ChatGPT) est essentiellement un portrait très détaillé de la classe « texte écrit par des humains », assez précis pour produire du texte nouveau, mot après mot. Les générateurs d’images font la même chose avec les photos. Le Module 4 leur est consacré.
Pour établir le portrait d’une classe, on décrit comment ses points se répartissent le long de chaque caractéristique. Par exemple, les points bleus se concentrent peut-être autour d’une certaine valeur de $x_1$, et les rouges autour d’une valeur plus élevée. Cette répartition se résume par une courbe connue, la courbe en cloche (ou gaussienne), qui présente un sommet là où les points sont nombreux et des bords qui s’abaissent là où ils sont rares. Le portrait d’une classe est donc formé de quelques-unes de ces cloches, une par caractéristique.
Pour garder le calcul simple, on fait une hypothèse volontairement approximative : on traite chaque caractéristique séparément, comme si elles étaient indépendantes. C’est rarement tout à fait vrai (la superficie et le nombre de pièces, par exemple, varient ensemble), et c’est ce que signifie le mot naïve dans le nom de la méthode. Cette méthode naïve est néanmoins très efficace en pratique.
Il reste une dernière étape. Les portraits répondent à la question « si ce point est bleu, à quel point est-il typique ? », c’est-à-dire à la probabilité du point sachant la classe. Ce qu’on veut, c’est l’inverse : la probabilité que le point soit bleu, étant donné ce point. Passer de la probabilité du point sachant la classe à la probabilité de la classe sachant le point est précisément ce que permet un résultat fondamental des probabilités, le théorème de Bayes, publié en 1763. C’est lui qui donne son nom à la méthode, la classification bayésienne naïve (naive Bayes).
On dispose donc de deux approches pour le même objectif :
| Régression logistique | Bayes naïf | |
|---|---|---|
| Philosophie | discriminative | générative |
| Stratégie | tracer la frontière | décrire chaque classe |
| Question posée | de quel côté ? | à quel portrait ressemble-t-il le plus ? |
| Bonus | — | pourrait générer de nouveaux exemples |
Sur nos données en deux dimensions, ces deux approches très différentes aboutissent à la même forme de frontière, une droite. La distinction entre apprendre à séparer et apprendre à décrire reste cependant l’une des plus importantes du domaine. Nous la retrouverons au Module 4, qui distingue les modèles qui classent et ceux qui produisent du contenu.
Les mathématiques de la classification bayésienne naïve (optionnel)
Chaque couple caractéristique + classe est modélisé par une gaussienne à une dimension. Avec nos deux caractéristiques et nos deux classes, cela fait quatre cloches. La gaussienne (ou loi normale) décrit comment la « masse de probabilité » se répartit autour d’une valeur centrale, la moyenne :
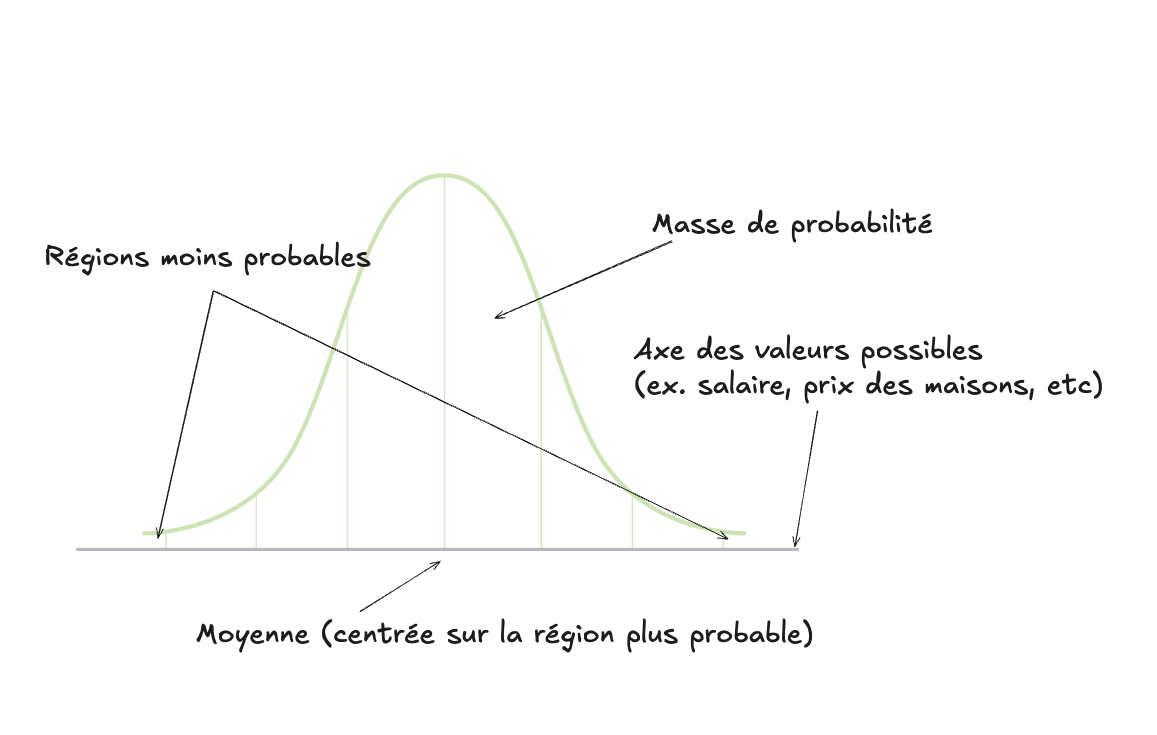
La hauteur de la courbe en un endroit n’est pas la probabilité de ce point. Comme la courbe est continue, une probabilité correspond à une aire sous la courbe (entre deux bornes). L’aire totale vaut 1, et l’aire à gauche de la moyenne vaut donc 0,5.
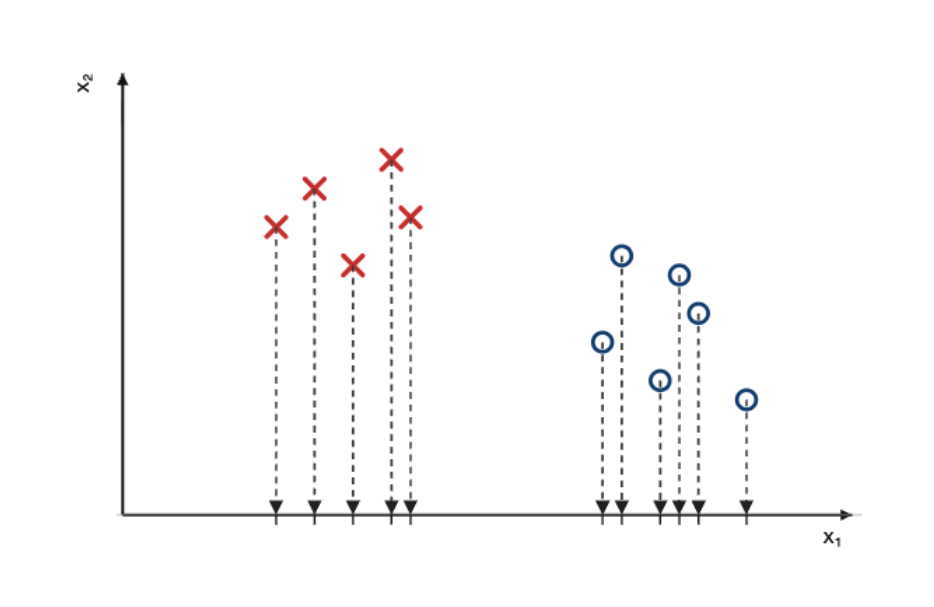
Concrètement, on projette d’abord les points sur l’axe $x_1$, ce qui les rend unidimensionnels…
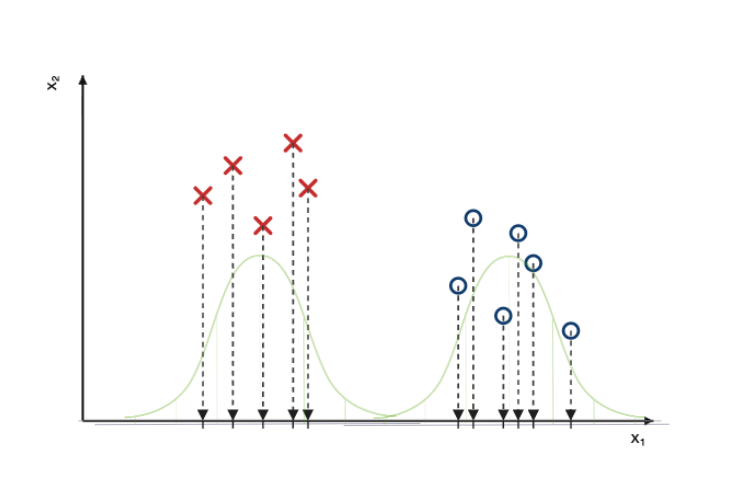
…puis on ajuste une cloche par classe, dont la largeur correspond à la dispersion des points projetés :
On fait ensuite la même chose sur l’axe $x_2$ :
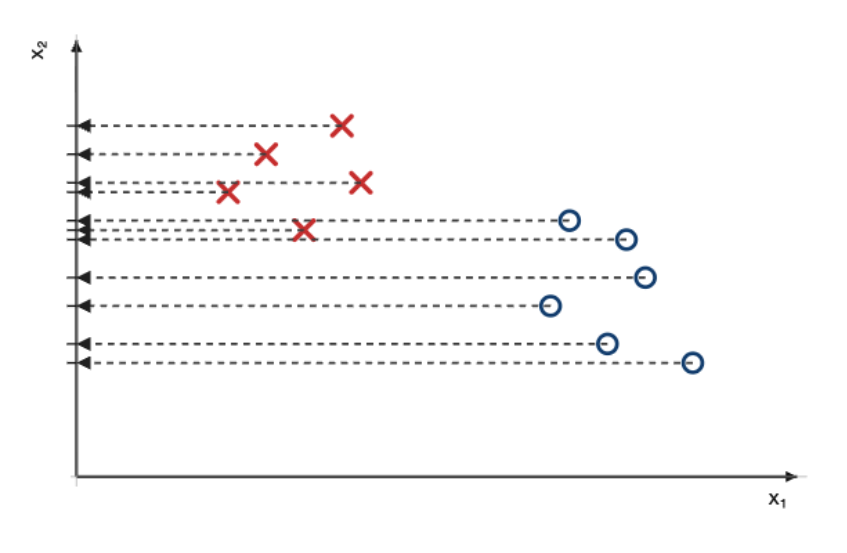
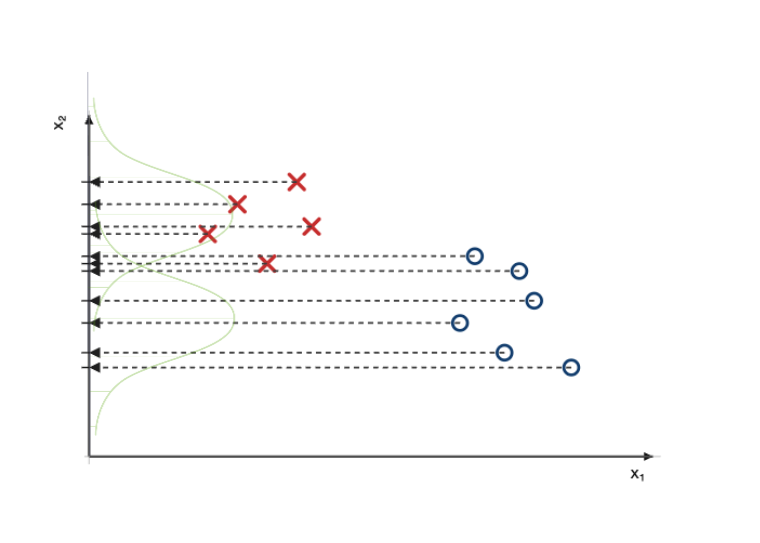
On dispose alors de quatre modèles $p(x_j \mid \text{classe})$. La moyenne $\mu$ et l’écart-type (standard deviation) $\sigma$ de chaque cloche s’obtiennent directement par un calcul de moyenne et de dispersion sur les points concernés. Aucune descente de gradient itérative n’est nécessaire ici :
$$\hat\mu_{j,c} = \frac{1}{N_c}\sum_{i \in c} x_{ij}, \qquad \hat\sigma^2_{j,c} = \frac{1}{N_c}\sum_{i \in c} \big(x_{ij} - \hat\mu_{j,c}\big)^2$$L’hypothèse naïve d’indépendance permet de combiner les caractéristiques par simple multiplication :
$$p(\mathbf{x} \mid c) = p(x_1 \mid c)\,\cdot\,p(x_2 \mid c)$$Ce modèle est génératif : il décrit la probabilité d’un point $\mathbf{x}$ sachant sa classe, $P(\mathbf{x} \mid y)$. La classification demande l’inverse, $P(y \mid \mathbf{x})$. Le théorème de Bayes permet ce passage :
$$P(y \mid \mathbf{x}) = \frac{P(\mathbf{x} \mid y)\,P(y)}{P(\mathbf{x})}$$Ici, $P(y)$ est la proportion de chaque classe (souvent 50/50 si les données sont équilibrées). Comme le dénominateur $P(\mathbf{x})$ ne dépend pas de la classe, on peut l’ignorer pour décider :
$$\text{classe}(\mathbf{x}) = \begin{cases} \mathtt{rouge} & \text{si } P(\mathbf{x}\mid\text{rouge})\,P(\text{rouge}) \ge P(\mathbf{x}\mid\text{bleu})\,P(\text{bleu}) \\ \mathtt{bleu} & \text{sinon} \end{cases}$$On détermine donc lequel des deux portraits rend le point observé le plus vraisemblable, et c’est ce portrait qui donne la classe.
Le cas des pourriels
Passons maintenant des points colorés à un problème réel, celui du travail noté
2 : reconnaître automatiquement les pourriels (les
courriels indésirables, le spam). C’est un exemple classique de
classification. Il y a deux classes, pourriel ou courriel légitime, et une
décision à prendre pour chaque message qui arrive.
Un premier obstacle se présente. Nos deux classificateurs attendent un point, c’est-à-dire une petite liste de nombres. Un courriel, lui, est un texte. Il faut donc trouver comment transformer un texte comme « Félicitations ! Vous avez gagné un prix… » en coordonnées.
La solution reprend la démarche de Regarder les données : une chose se décrit par une liste de nombres et devient ainsi un point dans un espace. Pour un texte, le procédé le plus simple s’appelle le sac de mots (bag of words). On établit la liste de tous les mots possibles (le vocabulaire), puis on décrit un courriel en comptant combien de fois chaque mot y apparaît. Chaque mot du vocabulaire correspond à une dimension, et la valeur est le nombre d’occurrences. Par exemple, le mot « gratuit » apparaît deux fois, « réunion » zéro fois, et ainsi de suite.
$$\mathbf{x} = (n_1, n_2, \ldots, n_V)$$La seule différence avec le vecteur d’une maison est l’échelle. Une maison se décrivait par quelques caractéristiques, alors que le vocabulaire compte des dizaines de milliers de mots. Un courriel est donc bien un point, mais dans un espace de très grande dimension. Comme nos points bleus et rouges, les pourriels et les courriels légitimes y forment deux nuages distincts :
Nous savons déjà traiter deux nuages dans un espace, et la méthode de la section précédente s’applique telle quelle. On établit le portrait de chaque classe (quels mots trouve-t-on dans un pourriel typique, et dans un courriel légitime ?), puis on classe un nouveau message en déterminant lequel des deux portraits rend ses mots les plus vraisemblables. Il s’agit encore de l’approche générative de Bayes naïf. Ici, l’hypothèse naïve consiste à supposer que les mots sont tirés indépendamment les uns des autres. C’est faux (« carte » appelle souvent « bancaire »), mais c’est commode et étonnamment efficace.
Un seul détail technique change par rapport à la section précédente. Les caractéristiques y étaient des valeurs continues, décrites par une courbe en cloche. Ici, ce sont des comptes, des nombres entiers : zéro, une ou deux occurrences, par exemple. On remplace donc la cloche par une loi adaptée aux comptes, la loi multinomiale (multinomial distribution), mais le principe est le même. Le portrait d’une classe n’est plus une moyenne et une dispersion, mais la liste des mots qu’elle emploie souvent. Des mots comme « gratuit », « urgent » ou « félicitations » sont fréquents dans les pourriels et beaucoup moins dans les courriels ordinaires.
C’est ce classificateur (Bayes naïf multinomial sur un sac de mots) que vous mettrez en œuvre au travail noté 2 pour construire votre propre filtre anti-pourriel.
Les mathématiques du Bayes naïf multinomial (optionnel)
Un courriel est le vecteur de comptes $\mathbf{x} = (n_1, \ldots, n_V)$, où $n_i$
est le nombre d’occurrences du mot $i$ et $V$ la taille du vocabulaire. Si ce
courriel appartient à la classe pourriel, la probabilité d’observer ce vecteur
selon la loi multinomiale est :
Ici, $N = \sum_i n_i$ est le nombre total de mots du courriel, et $p_i$ est la
probabilité, dans un pourriel, que le mot tiré soit le mot $i$ (par exemple plus
élevée pour « prix » que pour « parent »). On définit de la même façon un modèle
pour la classe courriel. Ces $p_i$ s’estiment directement, en comptant la
fréquence de chaque mot dans les courriels d’entraînement de la classe, comme on
estimait la moyenne d’une gaussienne.
La décision se prend ensuite avec le théorème de Bayes, comme à la section précédente. En ignorant le dénominateur $P(\mathbf{x})$, qui est le même pour les deux classes, on obtient :
$$\text{classe}(\mathbf{x}) = \begin{cases} \mathtt{pourriel} & \text{si } P(\mathbf{x}\mid\text{pourriel})\,P(\text{pourriel}) \ge P(\mathbf{x}\mid\text{courriel})\,P(\text{courriel}) \\ \mathtt{courriel} & \text{sinon} \end{cases}$$Ce calcul correspond à une décision linéaire dans l’espace des mots, soit le même genre de frontière que celle de la régression logistique. Les deux familles, discriminative et générative, aboutissent donc de nouveau au même résultat.
Raisonner sous incertitude : les réseaux bayésiens
Le classifieur de la section précédente appartient à un courant plus large, qui a transformé l’IA à la fin des années 1980. Les systèmes experts du Module 1 raisonnaient avec des règles. Pour tenir compte de l’incertitude, MYCIN leur ajoutait des facteurs de certitude, une méthode commode mais approximative. Au cours des années 1980, une autre idée s’impose : raisonner directement avec des probabilités, selon les règles du calcul des probabilités et le théorème de Bayes. On a appelé ce tournant la révolution probabiliste.
Il touche plusieurs domaines en même temps.
- La reconnaissance de la parole. Chez IBM, l’équipe de Frederick Jelinek remplace les règles de linguistes par des modèles statistiques appris sur des enregistrements. On lui attribue une phrase restée célèbre : chaque fois qu’il renvoyait un linguiste, son système s’améliorait.
- La traduction automatique. Vers 1990, une autre équipe d’IBM traduit par des probabilités apprises sur des textes déjà traduits, au lieu d’écrire des règles de grammaire.
- Les filtres anti-pourriel. En 2002, l’essai de Paul Graham, « A Plan for Spam », popularise le classifieur bayésien de la section précédente, que la plupart des messageries adoptent ensuite.
- Le raisonnement en général, avec les réseaux bayésiens (Bayesian networks) de Judea Pearl, présentés ci-dessous.
Du classifieur naïf au réseau. On peut dessiner le classifieur bayésien naïf comme un graphe. Un nœud représente la classe, « pourriel ou non », et une flèche part de ce nœud vers chaque mot, parce que la classe influence les mots employés. Il n’y a aucune flèche entre les mots : c’est l’hypothèse naïve.
Un réseau bayésien, proposé par Judea Pearl en 1985, généralise ce dessin. Chaque nœud est une variable incertaine. Chaque flèche indique une influence directe, en général d’une cause vers un effet. Chaque nœud porte une petite table, qui donne sa probabilité selon les valeurs de ses parents. Ces tables suffisent à calculer la probabilité de n’importe quel nœud, à partir de n’importe quelle observation.
Un exemple : l’alarme. Une maison a une alarme contre les cambriolages. Elle se déclenche aussi, parfois, lors d’un tremblement de terre. Si elle sonne, vos voisins Jean et Marie vous appellent peut-être. Jean appelle presque toujours, mais il appelle aussi parfois quand il confond l’alarme avec la sonnerie de son téléphone. Marie entend moins bien, mais se trompe rarement.
Dans l’applet ci-dessous, cliquez sur un nœud pour indiquer ce que vous savez : vrai, faux ou inconnu. Les probabilités des autres nœuds sont recalculées aussitôt.
- Sans aucune observation, la probabilité d’un cambriolage est de 0,1 %. Indiquez que l’alarme sonne. Elle passe à environ 37 %.
- Indiquez ensuite qu’il y a eu un tremblement de terre. La probabilité du cambriolage retombe à 0,3 %. Le séisme explique l’alarme, et le cambriolage n’est plus nécessaire pour l’expliquer. Ce raisonnement s’appelle l’explication concurrente (explaining away). Pourtant, dans le réseau, cambriolage et séisme sont indépendants l’un de l’autre.
- Effacez ces observations, puis indiquez seulement que Jean appelle : le cambriolage passe à 1,6 %. Avec Marie seule : 5,6 %. Avec les deux : 28 %. Deux indices faibles et indépendants, réunis, deviennent un indice fort.
Les flèches vont des causes vers les effets, mais le calcul va dans les deux sens. On part des effets observés, les appels, pour remonter vers les causes probables, le cambriolage ou le séisme. C’est le raisonnement d’un diagnostic, celui que MYCIN cherchait à mener avec ses règles. Le réseau le fait selon les règles exactes du calcul des probabilités.
Les réseaux bayésiens sont utilisés en diagnostic médical, en détection de pannes, en analyse de risques ou dans des filtres comme celui des pourriels. Pearl a ensuite cherché à distinguer, dans ces graphes, les influences causales des simples corrélations. Ces travaux sur la causalité lui ont valu le prix Turing en 2011. La distinction entre corrélation et causalité sera reprise au Module 5.
Les mathématiques des réseaux bayésiens (optionnel)
Un réseau bayésien décrit la probabilité conjointe (joint probability) de toutes ses variables comme un produit de petites tables. Pour l’alarme, avec $C$ (cambriolage), $S$ (séisme), $A$ (alarme), $J$ et $M$ (les appels) :
$$P(C, S, A, J, M) = P(C)\,P(S)\,P(A \mid C, S)\,P(J \mid A)\,P(M \mid A)$$Avec cinq variables vrai ou faux, la table complète compterait 32 cases. Le réseau n’a besoin que de 10 nombres. Pour obtenir une probabilité comme $P(C \mid A)$, on additionne les cases compatibles avec l’observation, puis on divise :
$$P(C \mid A) = \frac{P(C, A)}{P(A)}$$Ce calcul par énumération est exact, mais son coût double avec chaque variable ajoutée. Pour les grands réseaux, on utilise des algorithmes qui exploitent la forme du graphe, ou des méthodes d’approximation.
Sous les modèles, des probabilités
Avant de quitter la classification, il faut revenir sur une notion présente dans toute cette page, celle de probabilité. La régression logistique ne répond pas « bleu » ou « rouge », mais « bleu à 80 % ». Le classificateur bayésien compare lui aussi deux probabilités. Ce n’est pas un simple détail d’implantation. Un modèle qui donne une probabilité exprime une croyance avec son degré de certitude, et cette information est souvent plus utile que la seule décision. Un filtre qui rejette un courriel à 51 % n’indique pas la même chose qu’un filtre qui le rejette à 99,9 %. De plus, le seuil que nous déplacerons dans Bien évaluer un modèle n’existe que parce que le modèle exprime une incertitude. Il faut cependant que ces probabilités soient fiables : parmi les courriels qu’un bon modèle rejette « à 90 % », neuf sur dix doivent réellement être des pourriels. Cette propriété s’appelle la calibration, et on peut la vérifier.
Cette notion va plus loin. Rappelez-vous la fonction d’erreur de la droite, la moyenne des carrés des écarts, et celle de la régression logistique, qui pénalise d’autant plus le modèle qu’il se trompe avec assurance. Ces deux fonctions semblent sans rapport, mais elles découlent d’un même principe, l’un des plus importants de la statistique : le maximum de vraisemblance (maximum likelihood). Au lieu de chercher les paramètres qui réduisent l’erreur, on cherche les paramètres sous lesquels les données observées étaient les plus probables. Si l’on suppose que les prix des maisons s’écartent de la droite selon une courbe en cloche, chercher la droite qui rend les vingt prix les plus probables revient exactement à minimiser les carrés des écarts. Si l’on suppose que chaque étiquette est tirée avec la probabilité annoncée par le modèle, chercher les paramètres qui rendent les étiquettes observées les plus probables donne exactement la fonction d’erreur de la régression logistique. Minimiser une erreur et maximiser une vraisemblance sont donc deux descriptions de la même opération.
Nous avons employé le théorème de Bayes comme une formule, mais il décrit aussi une manière d’apprendre. On part d’une croyance a priori. Par exemple, avant de lire un courriel, on estime qu’il a une chance sur dix d’être un pourriel, parce que c’est la proportion habituelle. On observe ensuite des indices, ici les mots du courriel, et le théorème indique comment réviser la croyance. La probabilité a posteriori est la croyance de départ, corrigée selon ce que les indices rendent plus ou moins probable. Chaque mot lu modifie un peu l’estimation : « gratuit » la rapproche du pourriel, « réunion » du courriel légitime. La probabilité a posteriori d’aujourd’hui devient ensuite l’a priori de demain. Dans cette perspective, apprendre consiste à mettre à jour ses croyances à mesure que les indices arrivent, et le théorème de Bayes est la règle exacte de cette mise à jour. L’approche bayésienne est présente dans tout le domaine, y compris dans les méthodes qui cherchent aujourd’hui à faire indiquer aux grands modèles leur degré de certitude.
Tous les modèles de cette page apprennent leurs paramètres à partir des exemples, en optimisant un critère : une fonction d’erreur, une marge ou une vraisemblance. Avant d’examiner la qualité de leurs prédictions sur des données nouvelles, la page suivante, « Poser des questions : les arbres de décision », présente un dernier modèle, d’un autre type, qui ne calcule pas mais pose des questions.