Le problème
Quand vous regardez votre téléphone, il se déverrouille. Un courriel arrive et il est classé automatiquement dans les indésirables. Sur une chaîne de montage, une caméra repère, parmi des milliers de téléviseurs presque identiques, celui dont l’écran présente un défaut à peine visible. Une application vous suggère un film qui correspond à ce que vous aviez envie de voir ce soir.
Ces tâches font partie du quotidien. Elles ont cependant un point commun : personne ne sait écrire, ligne par ligne, les règles qui permettraient de les accomplir. Il est très difficile de décrire, par une suite d’instructions précises, ce qui distingue votre visage de tous les autres, ou ce qui fait qu’un courriel ressemble à un pourriel. On reconnaît ces choses en un instant, mais on ne sait pas les formuler.
C’est la limite à laquelle s’est heurtée l’IA classique du Module 1 : ce savoir est trop vaste et trop tacite pour tenir dans une liste de règles. L’apprentissage automatique adopte une autre stratégie. Au lieu de dicter les règles à la machine, on la laisse les découvrir.
Pourquoi on ne peut pas simplement le programmer
Pour comprendre ce qui change, il faut rappeler ce qu’est un programme informatique classique, comme celui qui fait fonctionner un tableur, un site de réservation ou une calculatrice. C’est une suite d’instructions explicites, écrites une à une par un programmeur, qui indiquent à l’ordinateur quoi faire, étape par étape : si telle condition, alors telle action. Quand une tâche peut être décrite par des règles claires, cette approche est très efficace.
Les exemples du début, cependant, ne se réduisent pas à des règles claires. Supposons qu’on veuille écrire une recette qui reconnaît un chat sur une photo. La règle « un chat a deux oreilles pointues » ne s’applique pas quand le chat est de dos, couché ou à demi caché derrière un meuble. La règle « il a le poil gris » ne s’applique pas à un chat roux ou noir, ni à un chat tigré sur un canapé tigré. Chaque règle entraîne de nombreuses exceptions, et la liste n’a pas de fin.
Ce phénomène s’appelle le paradoxe de Moravec. Les tâches que nous trouvons difficiles (jouer aux échecs, extraire une racine carrée) sont les plus faciles à programmer, parce qu’elles reposent sur des règles explicites. À l’inverse, ce qu’un enfant de trois ans fait sans effort, comme reconnaître un visage, attraper une balle ou comprendre une phrase, se laisse très difficilement mettre en règles, parce que cette compétence est perceptive et largement inconsciente. Comme nous ne savons pas comment nous faisons, nous ne pouvons pas l’écrire.
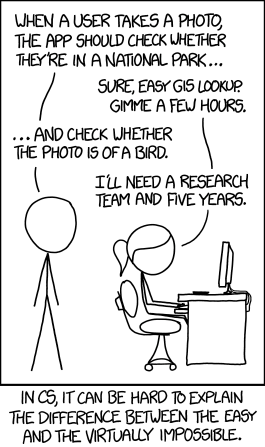
Traduction :
‐ « Quand un usager prend une photo, l’app devrait vérifier s’il est dans un parc national… »
‐ « Facile : un simple appel cartographique. Donne-moi quelques heures. »
‐ « … et vérifier si la photo est celle d’un oiseau. »
‐ « Là, j’ai besoin d’une équipe de recherche et de cinq ans. »
En informatique, la frontière entre le facile et le presque impossible n’est pas là où l’intuition la place.
Cette bande dessinée très connue a plus de dix ans, et son exemple a vieilli : identifier un oiseau dans une photo est devenu facile, justement grâce à l’apprentissage automatique. Son idée principale reste cependant exacte : certaines tâches d’apparence simple sont très difficiles pour un programme classique.
Changer de stratégie : apprendre à partir d’exemples
Comme nous ne savons pas énoncer les règles, on peut aborder le problème autrement. Au lieu de dicter les règles à la machine, on lui donne des exemples, c’est-à-dire des cas où la bonne réponse est déjà connue, et on la laisse trouver elle-même la régularité qui les relie.
Cette idée est proche de la façon dont un enfant apprend ce qu’est un chat. Il ne mémorise pas une définition. Il voit des dizaines de chats, jusqu’à ce qu’il sache les reconnaître sans pouvoir expliquer comment. On ne lui a jamais donné la règle ; il l’a extraite des exemples.
C’est le principe de l’apprentissage automatique (machine learning) : on fournit à un programme un grand nombre d’exemples, ainsi qu’une procédure qui lui permet d’ajuster son comportement jusqu’à reproduire les bonnes réponses. On espère ensuite qu’il répondra bien sur des cas qu’il n’a jamais vus. C’est le changement annoncé à la fin du Module 1 : au lieu de chercher une solution parmi des règles posées d’avance, le programme apprend à en construire une à partir des données.
Pour comprendre comment cela fonctionne concrètement, le plus simple est de partir d’un exemple modeste, qu’on pourra suivre du début à la fin et examiner sous plusieurs angles.
Notre fil rouge : des maisons à vendre
Photo : Kindel Media, Pexels.
Tout au long de ce module, nous suivrons un seul exemple, volontairement simple pour qu’on puisse en comprendre tous les détails : un registre de ventes immobilières. Nous poserons plus d’une question à ce même jeu de données (dataset).
Supposons qu’on dispose d’une liste de maisons récemment vendues, avec pour chacune quelques renseignements (sa superficie, son année de construction, son nombre de chambres) et surtout son prix de vente :
| Superficie (m²) | Année | Chambres | Prix |
|---|---|---|---|
| 180 | 1995 | 4 | 420 000 \$ |
| 150 | 1980 | 3 | 350 000 \$ |
| 220 | 2010 | 5 | 580 000 \$ |
| 130 | 1972 | 3 | 310 000 \$ |
| … | … | … | … |
La première question est la plus naturelle : combien vaut une maison ? Elle s’énonce simplement. Une nouvelle maison se présente, dont on connaît la superficie, l’année et le nombre de chambres, mais pas le prix, et il faut prédire ce prix.
Il y a clairement une régularité à exploiter : une grande maison récente vaut généralement plus cher qu’une petite maison ancienne. Cependant, « généralement » n’est pas une règle. C’est une tendance, qui comporte de nombreuses exceptions.
Si on ne garde que deux colonnes (la superficie et le prix), on voit déjà cette tendance : les points montent vers la droite, sans être parfaitement alignés. C’est ce genre de savoir approximatif que nous voulons faire émerger des exemples.
Une seconde question, d’une tout autre nature
Un agent immobilier se pose au moins deux questions sur une maison. La première, que nous venons de voir, est combien vaut-elle ? La seconde est tout aussi pratique : va-t-elle partir vite ? Les registres de ventes contiennent aussi les informations nécessaires, dans deux colonnes supplémentaires. La première donne la réponse. La seconde donne un renseignement qui ne nous avait pas servi jusqu’ici, mais qui va jouer un rôle important : la distance du centre-ville de la maison.
| Superficie (m²) | Année | Chambres | Distance du centre (km) | Prix | Vendue en moins de 30 jours ? |
|---|---|---|---|---|---|
| 180 | 1995 | 4 | 8 | 420 000 \$ | oui |
| 150 | 1980 | 3 | 21 | 350 000 \$ | non |
| 220 | 2010 | 5 | 9 | 580 000 \$ | oui |
| 130 | 1972 | 3 | 16 | 310 000 \$ | non |
| … | … | … | … | … | … |
Les deux questions portent sur les mêmes maisons, tirées du même registre. Cependant, les réponses attendues sont de nature différente. Dans le premier cas, la réponse est un nombre (420 000 \$, 385 200 \$, n’importe quelle valeur sur une échelle continue). Dans le second, c’est un choix entre deux réponses possibles, oui ou non. On ne peut pas faire la « moyenne » de oui et de non.
Cette différence est importante, parce qu’elle change le sens du mot se tromper. Prédire 405 000 \$ pour une maison vendue 420 000 \$ est une erreur, mais une erreur faible, dont on connaît la taille exacte : 15 000 \$. Répondre oui pour une maison qui s’est vendue lentement est simplement une erreur. Il n’y a pas de « presque oui », pas de demi-erreur, et aucune distance entre les deux réponses possibles. Dans le premier cas, on mesure un écart ; dans le second, la réponse est juste ou fausse. Nous verrons que cette différence a des conséquences sur tout le reste : la manière de prédire bêtement, la manière de mesurer l’erreur et la forme du modèle.
Pour cette seconde question, le prix devient un renseignement comme un autre, une colonne parmi les autres, au même titre que l’année de construction ou la distance du centre. Ce qui était la réponse à trouver dans le premier cas devient une donnée de départ dans le second. La table reste la même ; c’est la question qu’on lui pose qui change.
On peut aussi visualiser ce changement, à condition de choisir les bons axes. On laisse de côté la superficie et le prix, et on place les maisons dans un autre plan, avec la distance du centre en abscisse et l’année de construction en ordonnée. On colore ensuite chaque point selon la réponse à la nouvelle question :
La différence avec le premier graphique est nette. Dans le premier, on cherchait à deviner la hauteur du point, c’est-à-dire sa position sur une échelle continue. Ici, les deux coordonnées sont données, et on cherche la couleur. Le motif est clair : les points forment deux amas situés dans des coins opposés, séparés par un large espace vide. Les maisons proches du centre et récentes se vendent vite. Les maisons éloignées et anciennes se vendent lentement. Seules deux exceptions se trouvent dans l’espace vide.
On a changé de plan parce que, dans le graphique précédent (la superficie et le prix), les deux couleurs auraient été mêlées et n’auraient rien montré. Le motif était bien présent dans le registre, mais pas dans ces renseignements-là. Ce point annonce une leçon qui reviendra tout au long du module : la difficulté d’un problème tient souvent moins à la méthode qu’on applique qu’au choix de ce qu’on décide de regarder.
La couleur sert à régler un problème de place. Nous avons maintenant trois renseignements à représenter sur une page plane (la distance, l’année et la réponse). Les deux premiers occupent les axes. Pour le troisième, il ne reste pas d’axe disponible, et on le représente donc autrement. Il s’agit seulement d’une commodité de dessin. On peut le vérifier en donnant à la réponse un troisième axe, dans une vue en perspective :
Les maisons ne sont plus placées à n’importe quelle hauteur. Elles se trouvent sur l’un ou l’autre de deux plans. On passe d’un dessin à l’autre sans perdre d’information. Si on regarde ce relief d’en haut, à la verticale, on retrouve exactement le nuage coloré. La couleur correspondait donc à la projection du troisième axe. Les deux exceptions apparaissent aussi dans ce relief, qui explique pourquoi elles se remarquaient autant. La maison ancienne et éloignée qui s’est vendue vite se trouve sur le plan du haut, mais à la verticale de l’amas rouge. La maison récente et proche qui s’est vendue lentement se trouve sur le plan du bas, à la verticale de l’amas bleu. Le pointillé montre où chacune se place vue d’en haut, c’est-à-dire au milieu de l’autre couleur. Nous reprendrons cette figure au chapitre « Regarder les données », quand nous saurons quoi écrire sur ces deux barreaux.
Dans les prochains chapitres, nous suivrons surtout la première question, parce que le prix se prête mieux aux dessins et aux premières explications. La seconde question fera ensuite l’objet d’un chapitre entier, « Classer ». C’est d’ailleurs une question de ce type, ce courriel est-il un pourriel ?, que vous traiterez dans le travail noté. Nous verrons alors que presque tout ce qu’on aura appris pour l’une vaut aussi pour l’autre. Plusieurs des exemples du début de ce chapitre appartiennent à cette seconde famille. Reconnaître un chat ou repérer un pourriel sont des questions dont la réponse n’est pas un nombre, mais une catégorie.
Une catégorie peut avoir plus de deux valeurs, comme dans les questions suivantes. Quel animal est sur cette photo : un chat, un chien, un cheval ? Quel chiffre est écrit sur cette enveloppe ? (dix réponses possibles). Dans quelle langue ce message est-il rédigé ? Ce qui compte n’est pas le nombre de réponses, mais leur nature : une liste de possibilités distinctes, qu’on ne peut ni moyenner ni ranger sur une échelle. Il n’y a rien entre chat et chien, pas plus qu’entre oui et non. La question posée à nos registres, avec ses deux réponses, est le cas le plus simple de cette famille.
Avant de construire un modèle élaboré, il est utile de se demander quelle est la prédiction la plus bête possible, celle en dessous de laquelle il serait absurde de descendre. C’est par cette question que commence la suite du module.