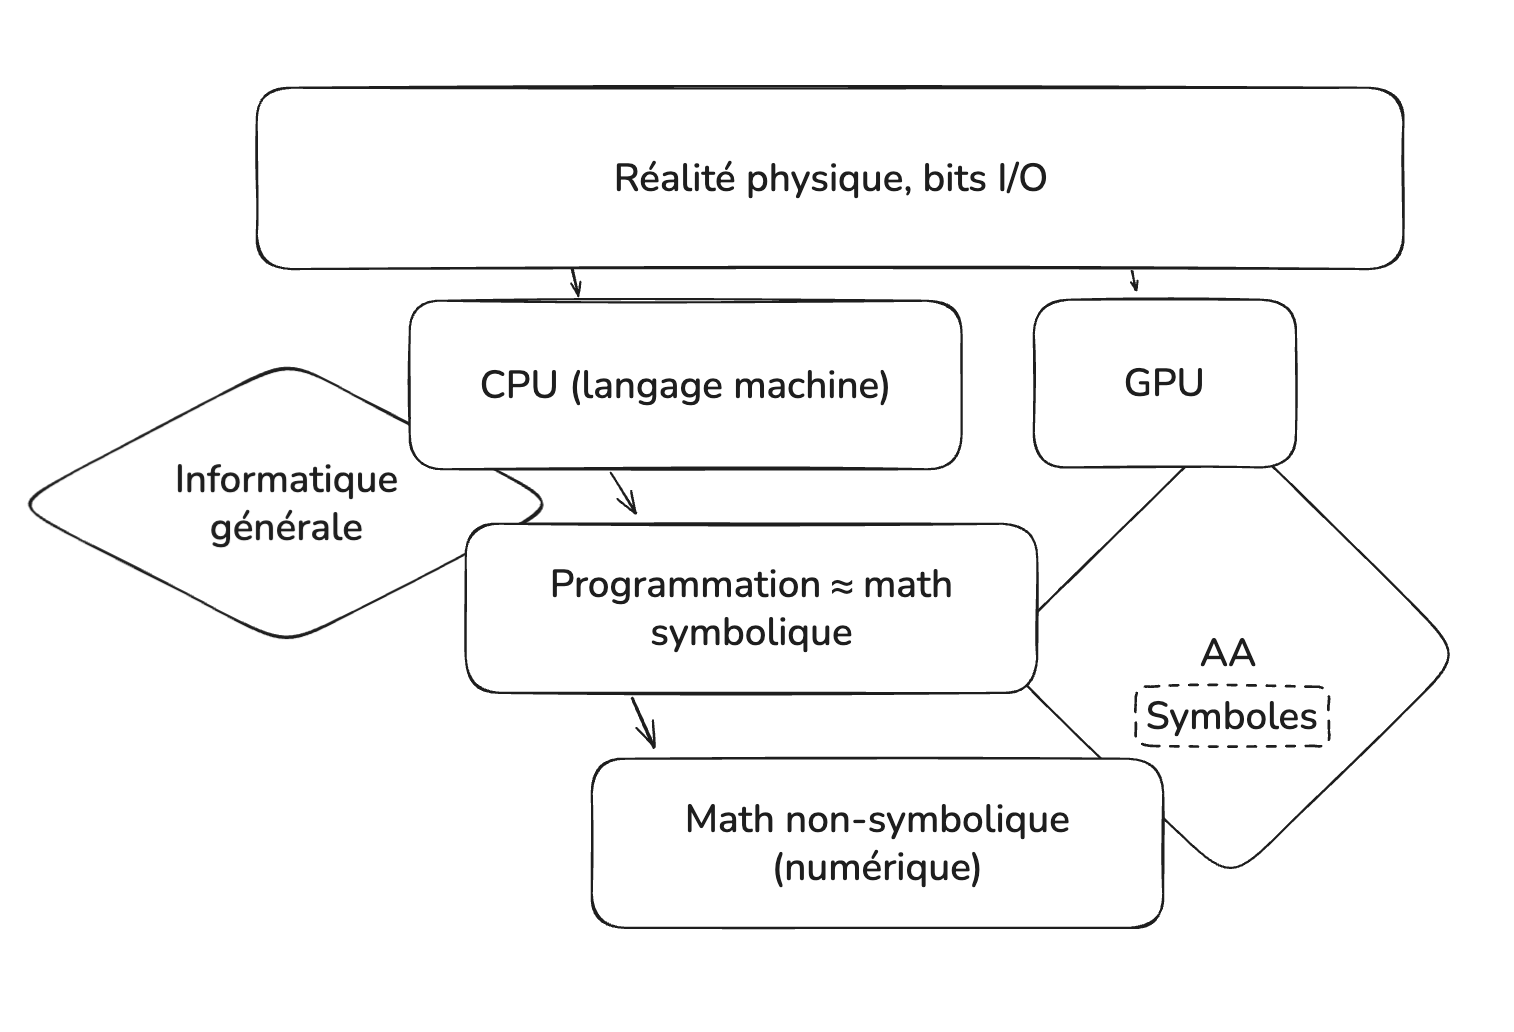
Regarder les données
La page « Le modèle le plus bête » s’est terminée sur une exigence : pour faire mieux que la moyenne, un modèle doit tenir compte des caractéristiques d’une maison (sa superficie, son âge, son nombre de chambres). Il faut donc les lui présenter sous une forme qu’il peut manipuler.
Une machine ne « voit » ni une maison, ni une photo, ni un courriel. Elle ne manipule que des nombres. La question est donc de savoir comment transformer un objet du monde réel en nombres sans en perdre l’essentiel. Cette question, plus profonde qu’il n’y paraît, est l’objet de cette page, et elle est un préalable à tout ce qui suit.
Une maison, c’est une liste de nombres
Reprenons notre table de maisons. Chaque ligne décrit une maison par quelques caractéristiques (en anglais features), c’est-à-dire des grandeurs mesurables :
| Superficie (m²) | Année | Chambres | Salles de bain | Prix |
|---|---|---|---|---|
| 180 | 1995 | 4 | 2 | 420 000 \$ |
| 150 | 1980 | 3 | 1 | 350 000 \$ |
| 220 | 2010 | 5 | 3 | 580 000 \$ |
| 130 | 1972 | 3 | 1 | 310 000 \$ |
Pour une machine, décrire la première maison consiste simplement à aligner ses caractéristiques :
$$\text{maison} \rightarrow (180,\ 1995,\ 4,\ 2)$$Une liste ordonnée de nombres comme celle-ci s’appelle un vecteur. L’objet peut être une maison, un client, un patient ou un courriel. Dès qu’on sait le décrire par quelques grandeurs, il devient un vecteur de nombres, et c’est ce vecteur qu’un modèle reçoit en entrée.
Une précision de vocabulaire servira dans toute la suite. Le prix ne fait pas partie de cette description, parce que c’est justement la valeur qu’on cherche à prédire. On l’appelle la cible (target). On a donc, d’un côté, les caractéristiques (l’entrée du modèle) et, de l’autre, la cible (sa sortie attendue).
Et quand la cible est une catégorie ?
Le prix est un nombre, donc il se prête sans difficulté à cette mise en forme. Notre seconde question était cependant différente : cette maison va-t-elle partir vite ? Le schéma est le même, avec deux différences. La sortie n’est plus un nombre, mais un oui ou un non. De plus, le prix, qui était la sortie, passe du côté de l’entrée et devient une caractéristique parmi les autres :
Or une machine ne manipule que des nombres. Il faut donc traduire le « oui » en nombre.
La façon la plus simple consiste à décider que oui vaut 1 et non vaut 0. Ce choix est arbitraire (on aurait pu prendre l’inverse, ou n’importe quel autre couple de valeurs), mais il a l’avantage de faire de la cible une grandeur comme une autre. Avec cette convention, une catégorie devient un nombre, et tout ce qui suit s’applique sans changement.
Le relief du chapitre « Le problème » ne change pas, sauf pour deux étiquettes : ses deux barreaux, non et oui, s’appellent maintenant 0 et 1. Ce changement est cependant important, parce que la réponse devient une grandeur comme les autres. Un modèle peut la calculer, la comparer et se tromper sur elle d’une quantité mesurable.
Il ne faut toutefois pas confondre cet axe avec les autres, car il n’est pas de même nature. La distance et l’année sont des caractéristiques : elles décrivent la maison et forment l’espace où elle se situe. La cible, elle, est ce qu’on cherche. Dans la suite, quand nous parlerons des dimensions d’un objet, il s’agira toujours de ses caractéristiques.
Nous pouvons maintenant nommer ces deux familles de problèmes, dont vous rencontrerez les noms partout :
- prédire un nombre (un prix, une température, une durée) s’appelle une régression ;
- prédire une catégorie (vendue vite ou non, pourriel ou courriel, chat ou chien, ou encore lequel des dix chiffres est écrit sur une enveloppe) s’appelle une classification.
La seule chose qui distingue ces deux familles est la nature de la cible. Cette distinction est pourtant l’une des plus utiles du domaine, parce que presque tout problème d’apprentissage à partir d’exemples étiquetés (labeled examples) appartient à l’une ou à l’autre. Nous les retrouverons souvent, et nous verrons que certains algorithmes savent faire les deux, alors que d’autres se spécialisent.
Un vecteur, c’est un point dans un espace
Représenter une maison par un vecteur de nombres ne fait pas que ranger ses caractéristiques. Cela lui donne aussi une place dans l’espace.
Prenons deux caractéristiques, la superficie et le nombre de chambres. On peut placer chaque maison comme un point sur un graphe, avec la superficie à l’horizontale et le nombre de chambres à la verticale. Une maison correspond alors à un endroit du plan, de la même façon que, dans le nuage des pages précédentes, chaque maison était déjà un point. Un vecteur à deux composantes est donc une position dans un plan.
Rien n’oblige à s’arrêter à deux caractéristiques. Si on ajoute l’année de construction, la maison devient un point dans un espace à trois dimensions, comme une mouche immobile quelque part dans une pièce. Avec une quatrième caractéristique, elle devient un point dans un espace à quatre dimensions. La règle est toujours la même : un objet décrit par n nombres est un point dans un espace à n dimensions.
Cette représentation géométrique est très utile. Deux maisons aux caractéristiques semblables sont deux points proches, et deux maisons très différentes sont deux points éloignés. La ressemblance entre objets devient donc une distance entre points. Le prochain chapitre, « Prédire par ressemblance », repose sur cette idée.
Quand il y a trop de dimensions pour les voir
Nos maisons n’avaient que trois ou quatre caractéristiques, et on pouvait presque les imaginer comme des points dans une pièce. Beaucoup d’objets du monde réel se décrivent cependant par beaucoup plus de nombres.
Prenons une image. Pour une machine, une photo est une grille de pixels, et chaque pixel est un nombre (ou trois nombres, pour ses quantités de rouge, de vert et de bleu).
On pourrait aussi la représenter autrement. Par exemple, s’il s’agissait d’une maison de jeu vidéo, on pourrait utiliser un modèle en trois dimensions, avec des axes x, y et z :
En apprentissage automatique, on procède autrement : on traite l’image entière comme un seul point, dans un espace où chaque pixel est une dimension. Une vignette de 100 × 100 pixels est ainsi un point dans un espace à 10 000 dimensions. Une photo ordinaire en compte des millions.
Il est impossible de se représenter un tel espace, puisque nous vivons dans un espace à trois dimensions. L’essentiel reste pourtant valable : la distance continue d’avoir un sens. Deux photos presque identiques sont deux points voisins, et deux images sans rapport sont deux points éloignés, comme pour nos maisons.
Le cas du texte est différent. Un courriel n’a ni superficie ni pixels, et rien ne semble s’y mesurer directement. On le décrit pourtant par des nombres, d’une façon qui paraît d’abord assez grossière. On dresse la liste de tous les mots qui peuvent y figurer (le vocabulaire) et, pour chacun, on compte combien de fois il apparaît dans le courriel. Chaque mot devient alors un axe. Prenons-en deux, gratuit et réunion, et plaçons quelques courriels dans leur plan :
Un courriel est donc un point dans un espace qui compte autant de dimensions que le vocabulaire compte de mots, soit des dizaines de milliers. Ce dessin n’en montre que deux. L’opération est la même que pour l’image et ses pixels :
Ces axes ne mesurent rien de physique, ni une taille ni une couleur. Ils contiennent seulement un compte, et l’ordre des mots est perdu. L’idée reste cependant valable : deux courriels qui emploient les mêmes mots sont deux points voisins, et un pourriel ressemble à d’autres pourriels. C’est cette représentation que nous utiliserons, au chapitre « Classer », pour construire un filtre.
On aurait pu décrire les courriels de façon encore plus grossière, en notant seulement si chaque mot est présent ou non, par 1 ou 0, au lieu de compter ses occurrences. Un tel axe n’a que deux barreaux, comme le relief non/oui du premier chapitre, et dans notre plan tous les courriels se retrouveraient aux quatre coins d’un carré. Compter les mots ou noter leur simple présence, avec un nombre entier ou avec 0/1, est un choix de représentation, et il en existe beaucoup d’autres. Nous garderons les comptes, qui sont plus précis.
L’idée s’applique donc à des objets très différents. Qu’il s’agisse d’une maison, d’une image ou d’un courriel, dès qu’on sait décrire un objet par des nombres, il devient un point dans un espace, et la ressemblance entre objets se mesure par leur proximité. Le prochain chapitre utilise cette idée pour prédire par ressemblance.
Sous le capot : des vecteurs aux bits (optionnel)
Nous avons dit qu’une machine « ne manipule que des nombres ». Il reste à préciser ce qu’est physiquement un nombre pour un ordinateur. Les paragraphes qui suivent descendent du vecteur jusqu’au signal électrique. Ils ne sont pas indispensables pour la suite du module, mais ils expliquent ce qui se passe à l’intérieur de la machine.
Niveau des bits
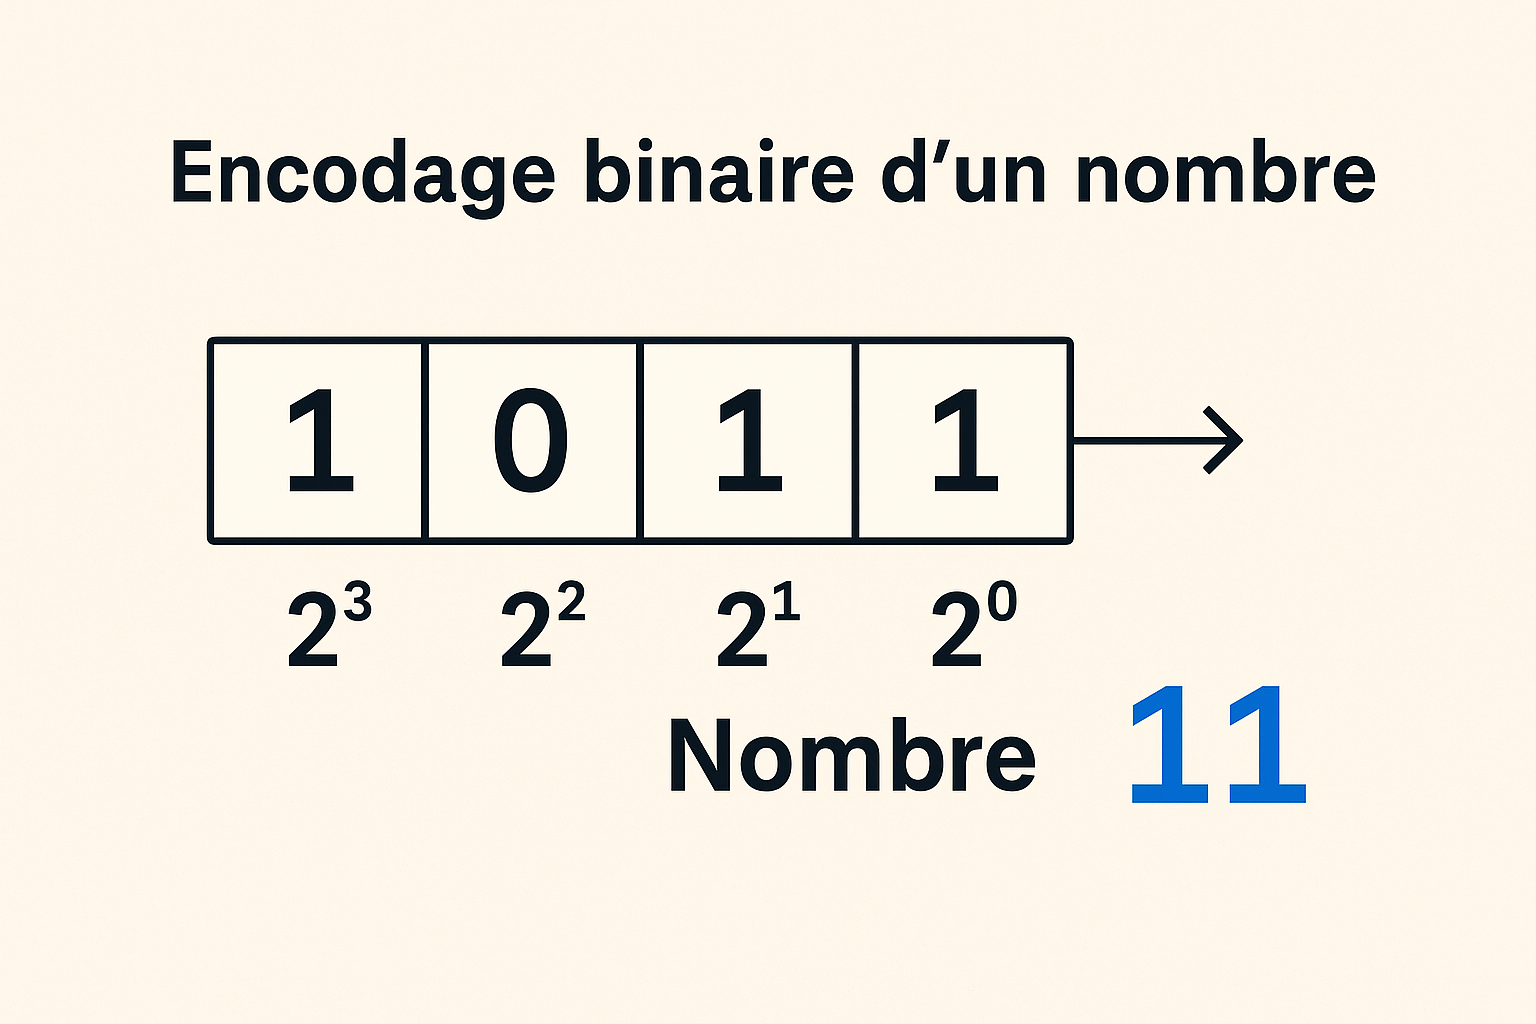
Au niveau le plus fondamental, l’ordinateur ne traite qu’un seul type de donnée,
le bit. Le bit est à la fois un concept mathématique (un symbole dont la
valeur ne peut être que 0 ou 1, ou vrai/faux en logique) et une réalité
physique, au niveau de l’implémentation : électrique (RAM, CPU, SSD), magnétique
(disque dur) ou optique (CD). Les bits représentent les nombres au moyen de la
convention de l’encodage binaire.
Niveau du processeur (le CPU)
Au niveau suivant se trouve l’ordinateur lui-même, dont le mécanisme central est le microprocesseur (CPU). Un CPU traite les bits sous leur forme physique. Il interprète des « paquets » (ou mots) de bits de taille fixe (souvent 32, 64 ou 128 bits) de deux manières très différentes :
- en tant que nombre (ou plus généralement valeur) ;
- en tant qu’instruction.
Le flot de bits que reçoit le CPU constitue un programme, que le CPU exécute dans l’ordre. Un programme dans un « langage machine » fictif pourrait être le suivant :
MOV 1000
ADD 0001
STR 2000
Les symboles MOV, ADD et STR sont des instructions, qui correspondent
elles-mêmes à des nombres. Le CPU pourrait voir la séquence suivante :
1000 1000
1001 0001
1002 2000
si MOV, ADD et STR correspondaient par convention aux valeurs 1000, 1001 et
1002. Le programme pourrait signifier ceci :
- Prendre la valeur à l'adresse mémoire 1000 et la mettre dans un registre
- Ajouter 1 à cette valeur dans le registre
- Enregistrer le contenu du registre à l'adresse mémoire 2000
Le CPU distingue 1000 instruction de 1000 valeur grâce à des conventions
établies à l’avance (par exemple, positions paires pour les instructions et
impaires pour les valeurs ; la réalité est un peu plus complexe, mais le principe
est celui-là). Pour réaliser une instruction, le CPU exécute un petit programme
câblé directement dans ses circuits. C’est à cet endroit que la logique rejoint la
matière.
Vous pouvez exécuter vous-même, pas à pas, une version interactive de ce petit programme :
Niveau des langages de programmation
Le niveau suivant est implémenté dans le langage du niveau précédent. De la même façon qu’on peut écrire un jeu ou un système d’exploitation (operating system) en langage machine, on peut y écrire un autre langage. Ce langage est plus abstrait, plus éloigné de la réalité physique, et il permet d’exprimer des idées plus complexes de façon plus naturelle (C++, Python, JavaScript). On peut le voir comme un « ordinateur virtuel » implémenté au moyen d’un langage moins abstrait. À ce niveau apparaissent des représentations beaucoup plus riches :
- des nombres entiers ;
- des nombres réels (beaucoup plus complexes à représenter) ;
- des chaînes de caractères (strings) ;
- des listes de nombres, de mots, de listes… ;
- des images, des sons ;
- etc.
C’est à ce niveau que sont écrits les algorithmes d’apprentissage automatique, et que se trouvent les vecteurs dont parle cette page.
Retour vers les symboles
Ces niveaux permettent de mieux comprendre la distinction souvent faite entre l’IA classique, qui manipule des symboles, et l’apprentissage automatique, qui manipule des valeurs numériques et qu’on qualifie parfois de sub-symbolique. Dans les deux cas, les données sont en fin de compte des valeurs numériques (et même des bits physiques). La distinction garde cependant un sens clair, parce que les deux approches reposent sur deux types de mathématiques différents.