Classification naïve bayésienne pour détecter les pourriels (travail noté 2)
La classification naïve bayésienne est un algorithme d’apprentissage supervisé qui repose sur les probabilités. Nous avons vu deux variantes de cet algorithme :
- La classification de simples points en 2d avec un modèle gaussien
- La classification de vecteurs en haute dimension avec un modèle multinomial
La classification de courriels est un problème classique qu’on peut traiter avec cet algorithme. On cherche à estimer la probabilité qu’un courriel soit un pourriel (spam) à partir des mots qu’il contient, parce que certains mots sont plus souvent utilisés dans les pourriels et d’autres dans les courriels.
Comme nous l’avons vu au chapitre « Classer », la classification naïve bayésienne est un algorithme
d’apprentissage génératif. On considère donc d’abord deux modèles (un pour
chaque classe, pourriel ou courriel), dont le rôle est de générer les données
observées plutôt que de les classifier directement :
ou, de manière plus compacte :
$$P(\mathbf{x} \mid \mathtt{pourriel})$$$$P(\mathbf{x} \mid \mathtt{courriel})$$Comme ce qui nous intéresse ici est de classifier les courriels, nous utilisons le théorème de Bayes pour « inverser » les modèles et obtenir une règle de classification simple, qui prédit la classe plutôt que les mots :
$$ \text{classification}(\mathbf{x}) = \left\{ \begin{array}{ll} \mathtt{pourriel} \text{ si } P(\mathbf{x} \mid \mathtt{pourriel}) P(\mathtt{pourriel}) \ge P(\mathbf{x} \mid \mathtt{courriel}) P(\mathtt{courriel}) & \\ \mathtt{courriel} \text{ sinon } & \\ \end{array} \right. $$Consignes
Suivez les instructions ci-dessous pour construire d’abord le fichier Google Sheets avec toutes les données nécessaires.
Une fois le fichier complété et fonctionnel, partagez votre fichier et copiez le lien vers celui-ci dans un document PDF (Attention : aucun autre format que PDF ne sera accepté).
Répondez aux questions d’interprétation de la dernière section dans le même fichier PDF, en fournissant des réponses claires et précises.
Entraînement du modèle
Cette section montre comment calculer ces probabilités en entraînant un modèle de classification sur une série de courriels.
Comme nous allons utiliser le tableur en ligne Google Sheets, assurez-vous d’abord qu’il est correctement configuré.
Copiez d’abord ces 10 mini-courriels dans la colonne A d’une nouvelle « feuille » Google Sheets, un courriel par rangée (si vous utilisez le copier-coller, assurez-vous de bien appliquer la fonction « copier-coller ») :
voici le colis est arrivé
bonjour voici le lien
offre spéciale colis gratuit
merci pour votre colis
colis livré demain matin
voici votre carte gratuite
réunion demain à midi
voici le code pour carte
livraison spéciale pour vous
merci encore pour votre carte
Pour avoir un aperçu de la tâche d’étiquetage des données (qui, dans un scénario
réel, peut être très coûteuse et laborieuse), nous vous proposons d’abord de
catégoriser vous-mêmes les courriels dans la colonne B, en utilisant la valeur
oui si vous considérez qu’il s’agit d’un pourriel, ou non (ce n’est pas un
pourriel) sinon.
Si vous préférez ne pas faire cet exercice maintenant, vous pouvez copier ces
valeurs (dans la colonne B) :
non
non
oui
non
non
oui
non
non
oui
non
À ce stade, votre feuille devrait ressembler à ceci :
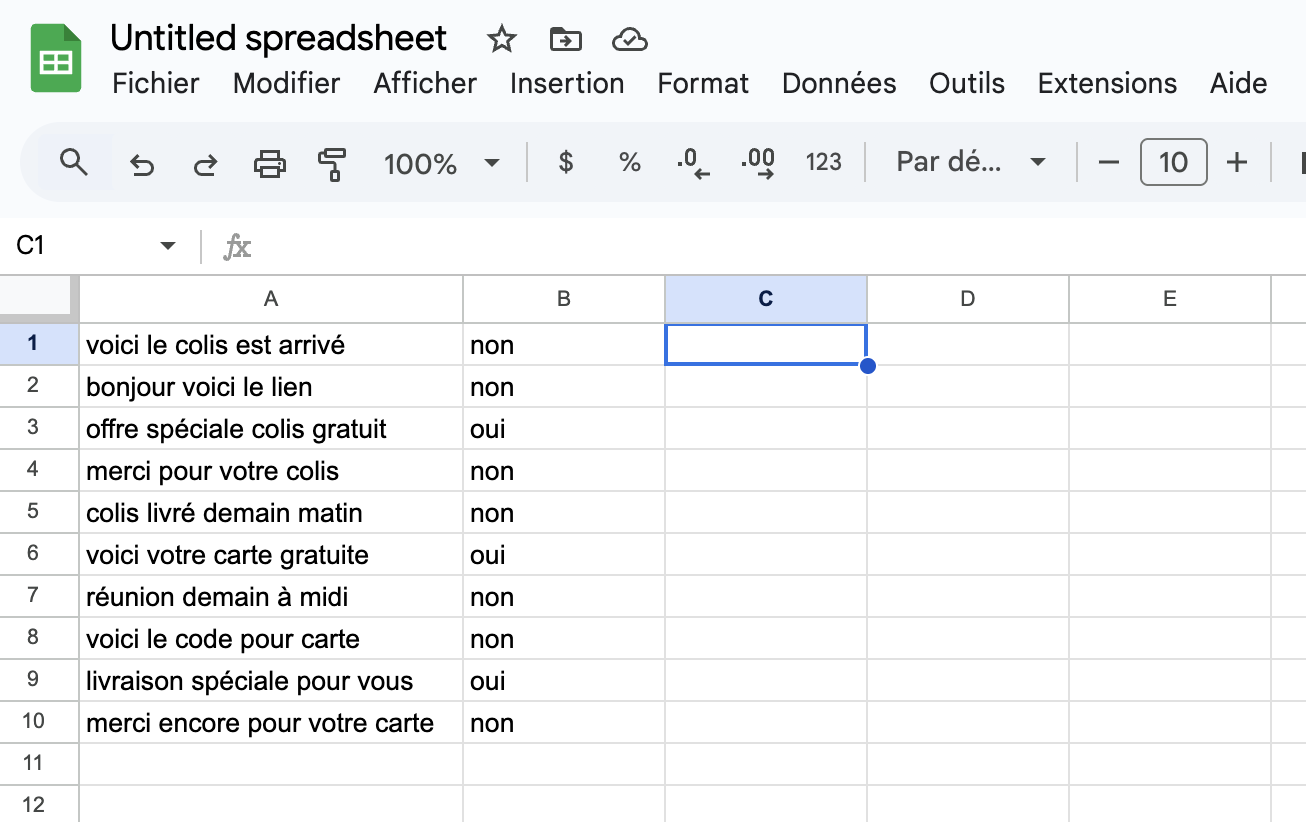
Calculez d’abord, dans la colonne C, la probabilité a priori qu’un courriel
quelconque ne soit pas un pourriel (C1) ou qu’il en soit un (C2), sans tenir
compte des mots pour le moment. Dans la cellule C1 :
=COUNTIF(B1:B10, "non") / COUNTA(B1:B10)et dans la cellule C2 :
=COUNTIF(B1:B10, "oui") / COUNTA(B1:B10)Si vous obtenez une erreur avec la formule à ce stade, il est très possible que les paramètres linguistiques de votre Google Sheets ne soient pas correctement configurés.
Ces probabilités a priori serviront plus loin. Définissez ensuite la colonne D
avec cette formule :
=UNIQUE(TRANSPOSE(SPLIT(TEXTJOIN(" ", TRUE, A:A), " ")))La colonne D devrait maintenant contenir le vocabulaire des courriels :
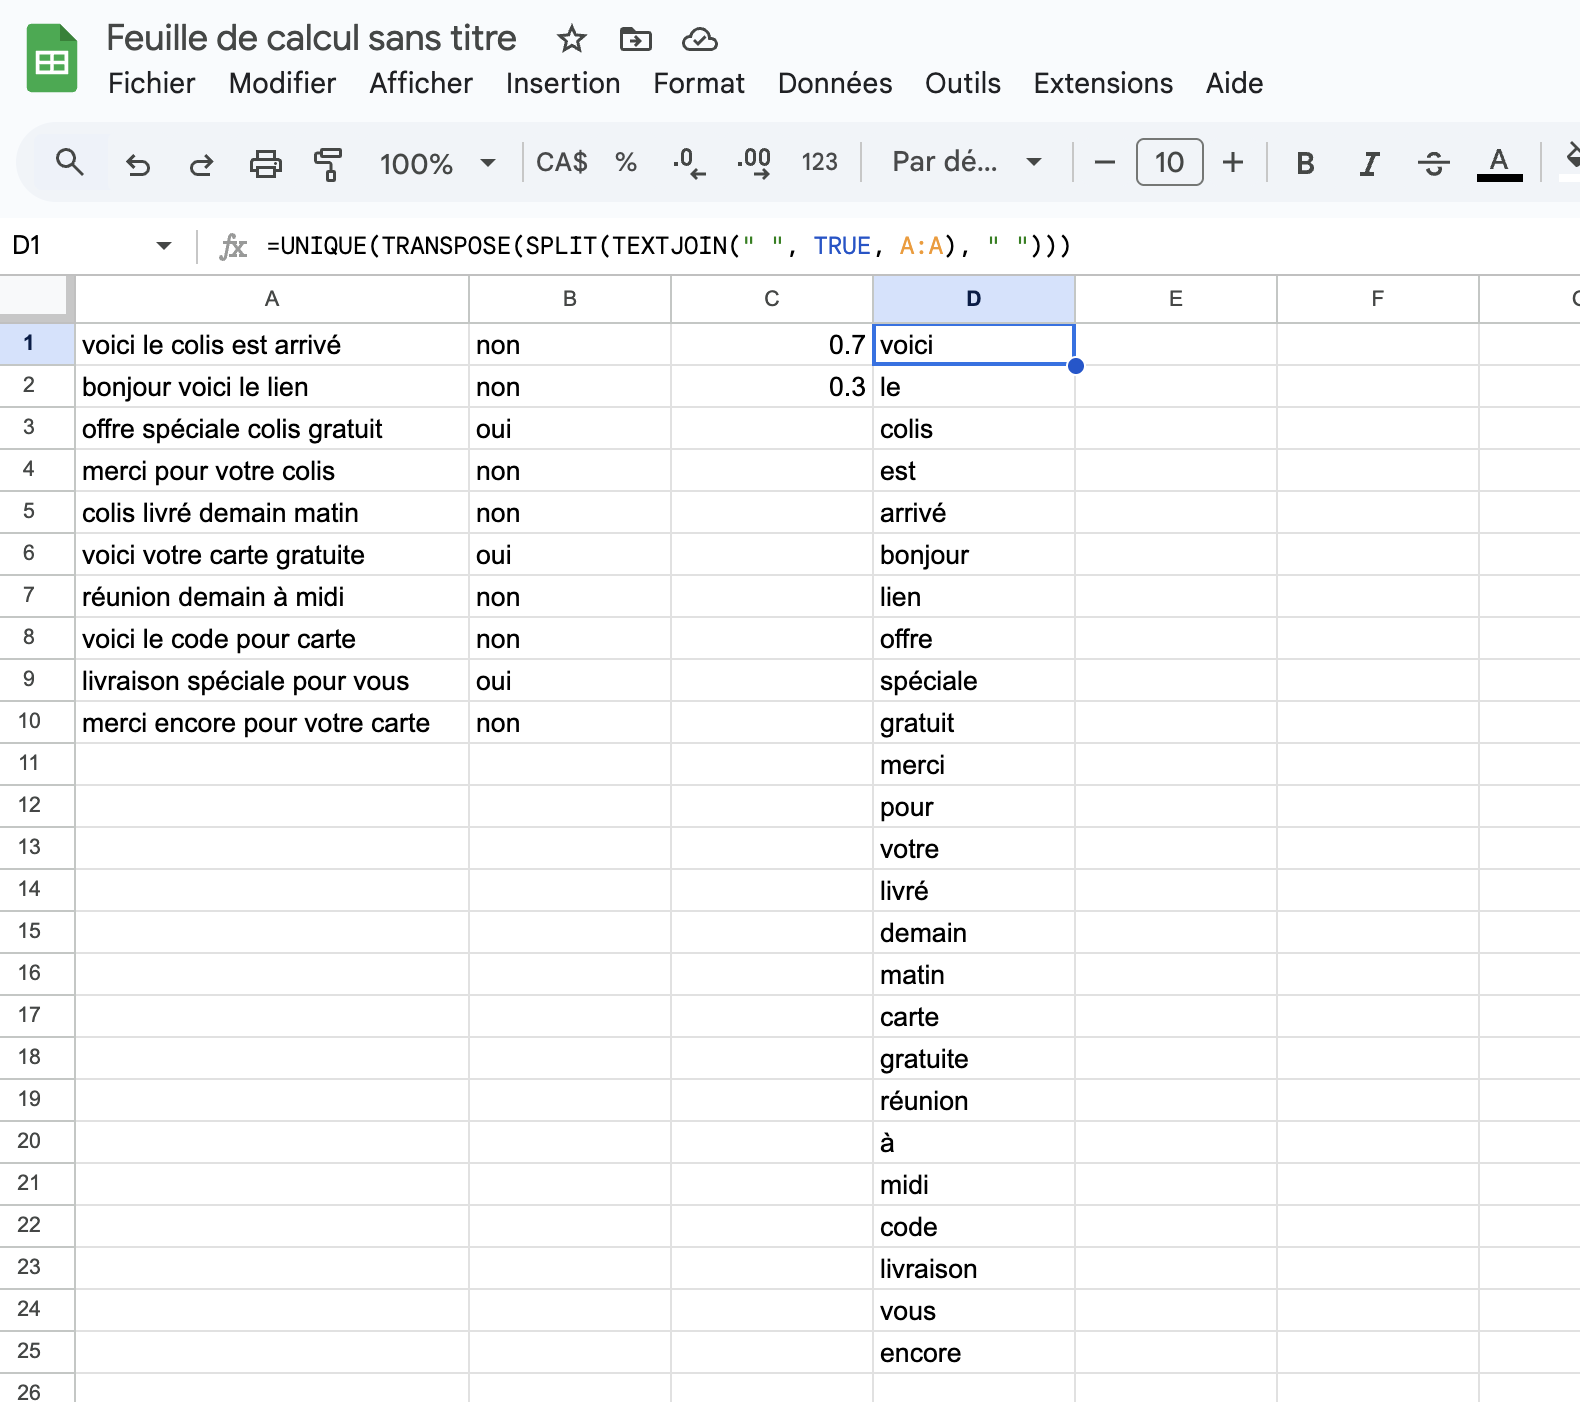
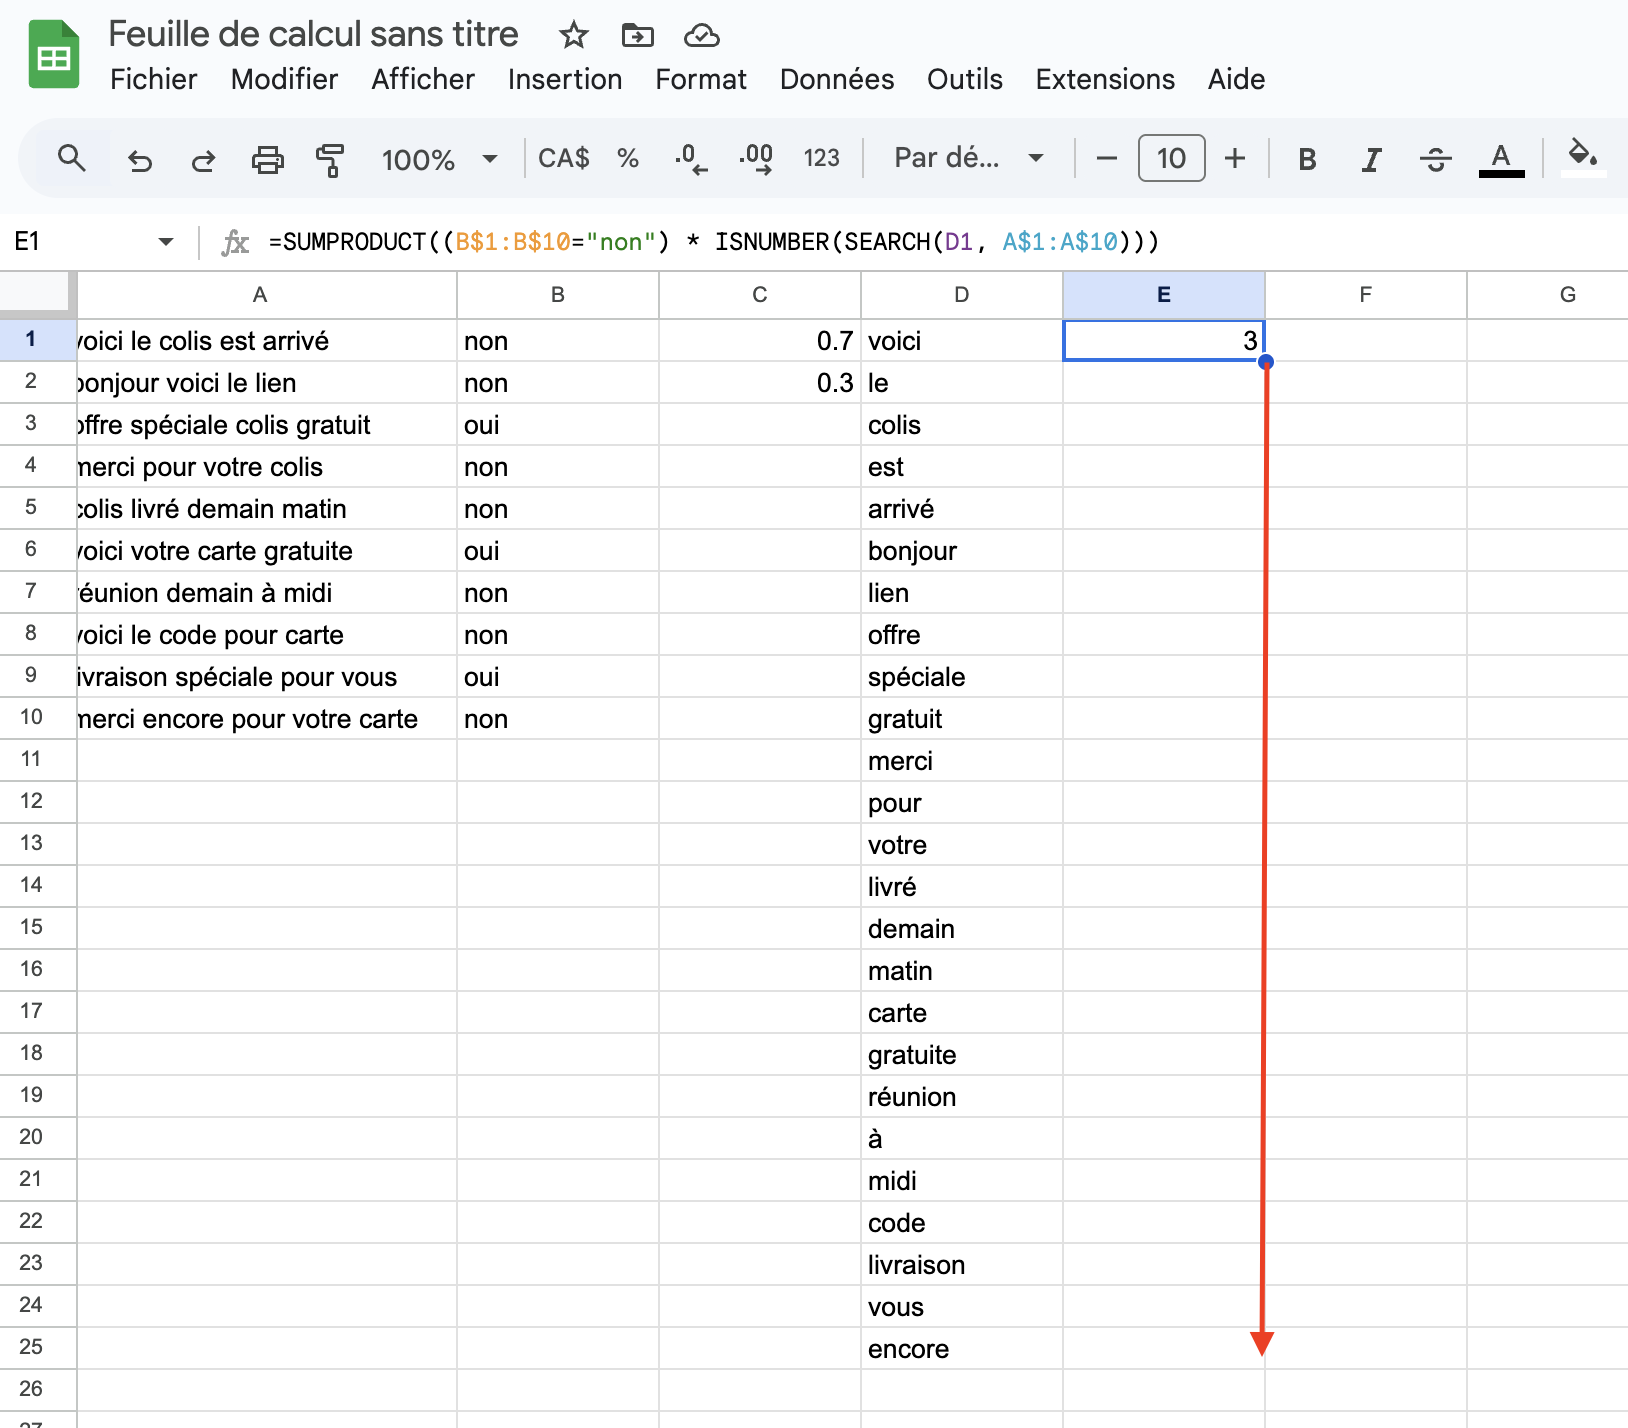
La colonne E doit ensuite contenir le nombre de courriels valides (ceux
marqués non, qui ne sont pas des pourriels) dans lesquels apparaît chaque mot
de la colonne D :
=SUMPRODUCT((B$1:B$10="non") * ISNUMBER(SEARCH(" " & D1 & " ", " " & A$1:A$10 & " ")))La formule entoure le mot et chaque courriel d’espaces avant de chercher l’un dans l’autre. Sans cette précaution, le mot « le » serait trouvé à l’intérieur de « spéciale », et « gratuit » à l’intérieur de « gratuite ».
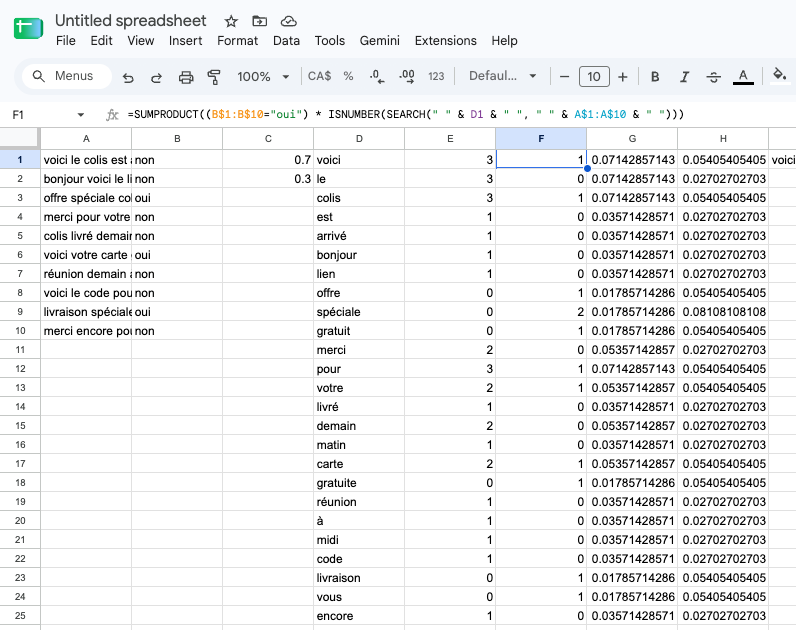
De la même manière, la colonne F contient, pour chaque mot, le nombre de
courriels marqués oui, qui sont des pourriels, dans lesquels il apparaît :
=SUMPRODUCT((B$1:B$10="oui") * ISNUMBER(SEARCH(" " & D1 & " ", " " & A$1:A$10 & " ")))Notez que les colonnes
EetFdoivent avoir le même nombre d’éléments que la colonneD. Il faut donc utiliser la fonction de remplissage automatique. Le plus simple est de glisser (drag) la première cellule vers le bas, une fois qu’elle a été calculée, ou de double-cliquer sur le petit carré bleu qui apparaît en bas à droite de la cellule sélectionnée. Google Sheets propose parfois de lui-même ce remplissage (« Remplissage automatique suggéré ») : vous pouvez l’accepter.
À partir de ces fréquences de mots pour chaque classe (oui ou non), on peut
maintenant calculer la probabilité conditionnelle de chaque mot du vocabulaire,
selon que le courriel est un pourriel (oui) ou non (non). La colonne G
correspond à la probabilité des mots sachant que le courriel n’est pas un
pourriel (non) :
=(E1 + 1) / (SUM(E:E) + COUNTA(D:D))De la même manière, la colonne H contient la probabilité des mots sachant que
le courriel est un pourriel (oui) :
=(F1 + 1) / (SUM(F:F) + COUNTA(D:D))Les colonnes G et H doivent elles aussi avoir la même taille que le
vocabulaire (colonne D). Il faut donc utiliser le remplissage automatique
décrit plus haut.
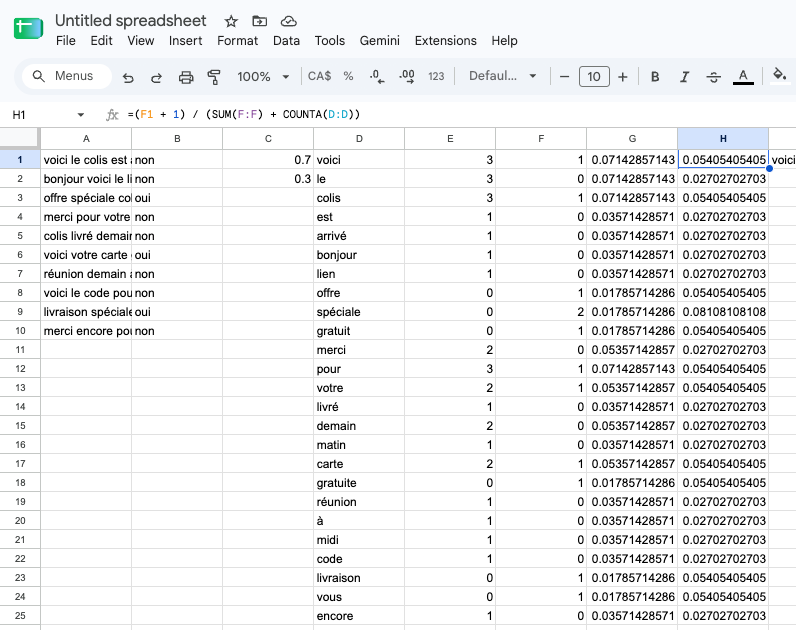
Le modèle est maintenant entièrement entraîné et prêt à être utilisé.
Utilisation du modèle (inférence)
Nous allons maintenant utiliser le modèle pour déterminer si un nouveau courriel
(qui n’a pas servi à l’entraînement) est un pourriel ou non. Dans la colonne I,
entrez un courriel à tester :
voici votre carte spécialeExtrayez les mots du courriel dans la colonne J :
=TRANSPOSE(SPLIT(I1, " "))Il faut ensuite, dans la colonne K, la probabilité des mots de ce courriel de
test dans l’hypothèse où ce n’est pas un pourriel (non) :
=IFERROR(XLOOKUP(J1, D:D, G:G), 1E-5)De la même manière, la colonne L contient la probabilité des mots du courriel
dans l’hypothèse où il s’agit d’un pourriel (oui) :
=IFERROR(XLOOKUP(J1, D:D, H:H), 1E-5)Les colonnes K et L doivent avoir la même taille que la colonne J.
Utilisez donc le remplissage automatique. Calculez ensuite, dans la colonne M,
la probabilité que le courriel ne soit pas un pourriel (non) :
=PRODUCT(K:K) * C1Dans la colonne N, calculez la probabilité que le courriel soit un pourriel
(oui) :
=PRODUCT(L:L) * C2La classification finale se trouve dans la colonne O :
=IF(M1 > N1, "non", "oui")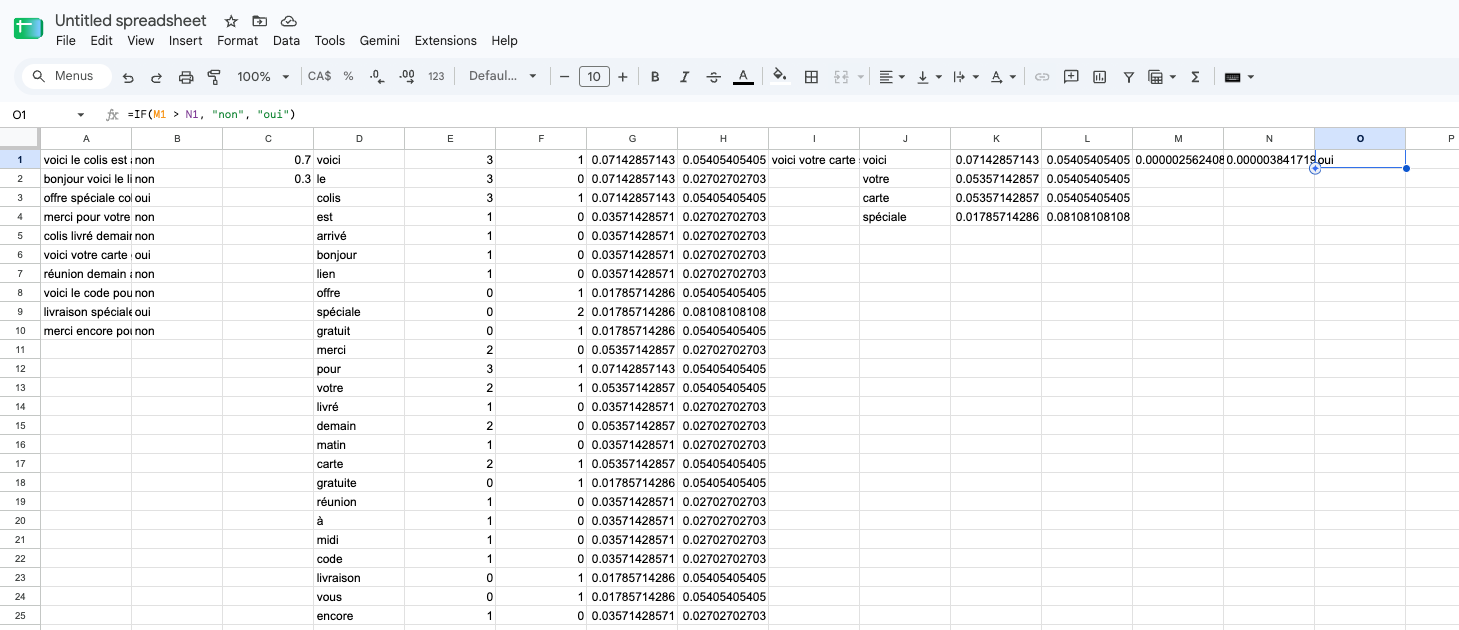
Questions d’interprétation
Que se passe-t-il si vous remplacez le mot « spéciale » par le mot « livrée » dans le courriel de test de la cellule
I1?Après ce changement, expliquez les probabilités qu’on trouve aux cellules
K4etL4associées au nouveau mot « livrée ». D’où proviennent ces nouvelles valeurs, et pourquoi a-t-on besoin d’y avoir recours dans le calcul ?Est-ce que ce modèle est paramétrique ou non ? Expliquez pourquoi.
S’il s’agit d’un modèle paramétrique, quels sont les paramètres du modèle (quelles colonnes) ?
Quelles colonnes constituent la partie générative du modèle ? Expliquez pourquoi.
Quelles colonnes constituent la partie discriminative du modèle ? Expliquez pourquoi.
Quelle est la signification des nombres dans les cellules
G11etH11, associées au mot « merci » ? Comment peut-on les interpréter ?Quelles sont les probabilités non conditionnelles (a priori) ? À quoi servent-elles ?
Est-ce qu’il serait possible d’utiliser seulement ces probabilités non conditionnelles pour faire un modèle de classification ? Quelles conséquences cela entraînerait-il ?
De quelle manière peut-on dire que ce modèle généralise ?
Est-ce que l’ordre des mots joue un rôle dans les décisions de ce modèle ? Expliquez pourquoi.
Si l’ordre des mots ne joue pas de rôle, comment pourrait-on modifier le modèle pour qu’il en joue un ?
Est-ce que certains mots aident particulièrement le modèle ? Si oui, pourquoi ?
Est-ce que certains mots sont moins utiles ? Si oui, pourquoi ?