Apprivoiser un réseau de neurones (travail noté 3)
Ce travail utilise TensorFlow Playground, une application en logiciel libre que nous avons adaptée pour ce cours. Elle entraîne sous vos yeux un petit réseau de neurones à classer des points de deux couleurs, et montre à chaque instant la frontière qu’il trace.
Lire l’application
- À gauche, le jeu de données. Chaque point est orange ou bleu. Le curseur « Bruit » mélange les deux groupes.
- Au centre, les caractéristiques (features) données au réseau. X₁ et X₂ sont les deux coordonnées d’un point, et les autres (X₁², X₁X₂…) sont calculées à partir d’elles. À leur droite, les couches cachées (hidden layers), qu’on ajoute ou retire avec les boutons + et −.
- À droite, la réponse du réseau : la couleur du fond montre la classe qu’il prédit en chaque point. La perte (loss) est l’erreur du réseau, au sens de la fonction d’erreur du Module 2. Plus elle est basse, mieux le réseau classe les points.
- En haut, le bouton de lecture lance l’entraînement. Le bouton de réinitialisation, la flèche circulaire, tire de nouveaux poids de départ au hasard. Le compteur indique le nombre d’époques (epochs), au sens de « Entraîner un réseau ».
Si l’application est coupée sur votre écran, ouvrez-la en pleine page.
Consignes
- Faites les expériences proposées dans les questions ci-dessous, avec l’application.
- Répondez aux questions dans un fichier PDF (aucun autre format ne sera accepté). Les réponses doivent être claires et précises.
Questions
Un problème facile
Parmi les quatre jeux de données proposés, lequel vous semble le plus facile à classer, en séparant les points orange des points bleus, pour un algorithme d’apprentissage automatique en général, et pas seulement pour un réseau de neurones ? Expliquez pourquoi.
Choisissez le jeu des deux groupes de points disposés en diagonale.
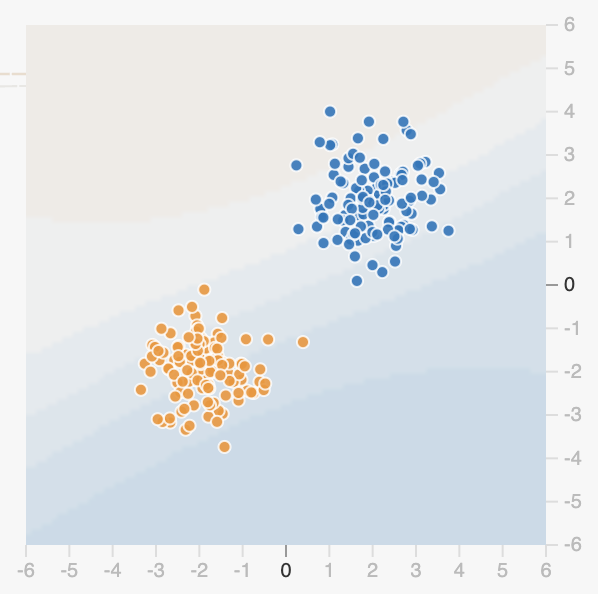
Vérifiez qu’il n’y a aucune couche cachée et que seules les caractéristiques X₁ et X₂ sont activées. Quelle est la perte d’entraînement ? Appuyez plusieurs fois sur le bouton de réinitialisation et observez comment varie cette perte initiale, avant tout entraînement.
Que signifient ces variations ? Pourquoi la perte initiale est-elle parfois haute et parfois basse, et comment le voit-on sur le graphique ? (Voir « Un réseau qui apprend le XOR ».)
Sans couche cachée, ce réseau ne contient qu’un seul neurone de sortie. Lancez l’entraînement avec ce bouton :
Quel modèle du Module 2 retrouve-t-on ainsi, et pourquoi ? (Voir « Un neurone est une régression logistique ».)
Réglez le bruit à 25, puis appuyez plusieurs fois sur « Régénérer ». Ce changement rend-il la classification plus facile ou plus difficile pour un algorithme d’apprentissage ? Expliquez pourquoi.
Le XOR
Remettez le bruit à 0 et choisissez le jeu du XOR, avec quatre groupes de points aux coins.
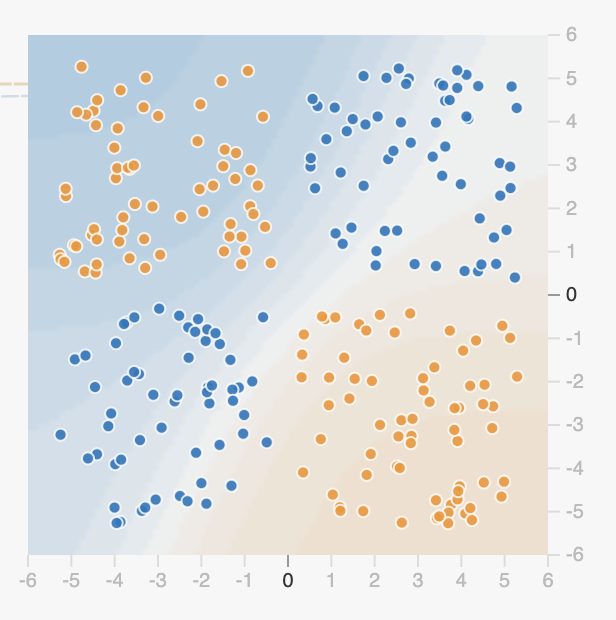
A priori, le réseau de la question précédente, sans couche cachée, peut-il classer ces points ? Expliquez pourquoi, puis faites l’essai. Que se passe-t-il ? (Voir le XOR au Module 1 et « Linéaire ou non-linéaire » au Module 2.)
Ajoutez une couche cachée de trois neurones, puis lancez l’entraînement. Quel est l’effet ? Comment l’expliquer ? (Voir « Une couche cachée ».)
Recommencez l’entraînement plusieurs fois, en appuyant sur le bouton de réinitialisation entre deux essais. Le réseau arrive-t-il toujours à la même frontière et à la même perte ? Comment l’expliquer ? (Voir « Un réseau qui apprend le XOR ».)
Ajoutez une deuxième couche cachée de deux neurones, et faites quelques entraînements. Qu’observez-vous par rapport à la question précédente ?
Retirez toutes les couches cachées, et n’activez que la caractéristique X₁X₂. Entraînez le modèle plusieurs fois. Qu’observez-vous, et comment l’expliquer ? Comparez avec la question 6 : dans chaque cas, qui a construit la caractéristique qui rend le problème séparable ? (Voir « Linéaire ou non-linéaire ».)
Le cercle
Choisissez le jeu du cercle, avec un groupe de points au centre entouré d’un anneau.
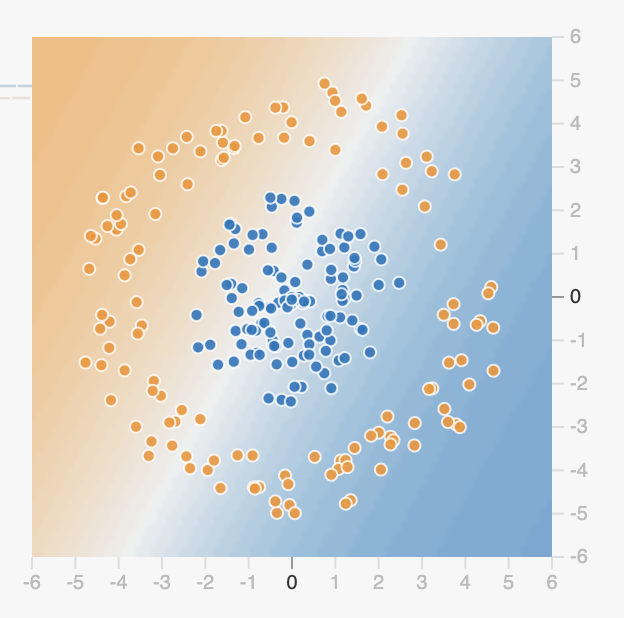
Sans couche cachée, et avec seulement X₁ et X₂, est-il possible de résoudre ce problème ? Pourquoi ?
Remplacez X₁ et X₂ par X₁² et X₂². La situation change-t-elle ? Comment l’expliquer ? Indice : pensez à l’équation d’un cercle. Quel lien faites-vous avec l’astuce du noyau du Module 2 ? Si la perte reste élevée, réinitialisez et relancez : il arrive que l’entraînement parte dans une mauvaise direction.
Revenez à X₁ et X₂ seulement. Peut-on réduire la perte en ajoutant des couches cachées ? Comparez avec la question précédente.
Entraîner trop longtemps
L’application ci-dessous est réglée autrement. Le jeu des deux groupes est très bruité, seuls 20 % des points servent à l’entraînement, et le réseau compte trois couches cachées de huit neurones. Les autres points forment le jeu de test (test set). Ils sont affichés avec un contour, et leur perte, la « perte de test », est indiquée au-dessus de la perte d’entraînement. Ne modifiez pas le ratio des données d’entraînement.
- Lancez l’entraînement et laissez-le tourner longtemps, plusieurs milliers d’époques. Observez les deux pertes et la frontière. Que se passe-t-il ? Quel nom donne-t-on à ce phénomène ? Comment pourrait-on l’éviter ? (Voir « Généraliser » et « L’entraînement en pratique ».)